 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
この記事では、ChatGPTのような大規模言語モデル(LLM)が、どんな手順で作られるのかを扱います。学習は事前学習・ファインチューニング・RLHFの3段階で進みます。あわせて、モデルを大きくすると性能が上がる「スケーリング則」と、学習データが抱える課題を見ていきます。
この単元を講義動画で見るIT資格の森の会員向け
講義2-2「生成AIの学習プロセス」(11分52秒)。この単元の内容を、動く図解で約12分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(2-1「生成AIを支える技術革新」)。(IT資格の森とUdemyの違い・料金)
3段階の全体像
LLMの作り方は、人が仕事を覚える流れに似ています。まず大量の本を読んで言葉と知識を身につけ(事前学習)、次に仕事の手本を見て「指示にどう答えるか」の型を学び(ファインチューニング)、最後に上司の評価を受けて答え方を磨きます(RLHF)。
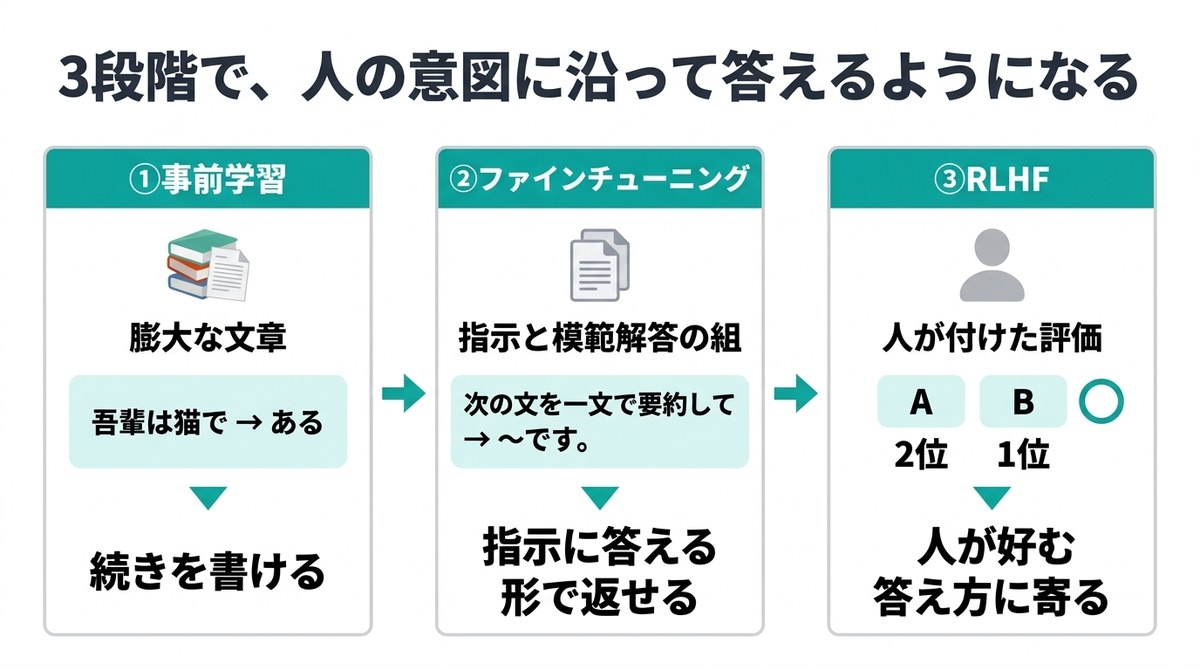
| 段階 | 使うデータ | 終わったときの状態 |
|---|---|---|
| 事前学習 | Webページや書籍などの膨大な文章 | 文章の続きを書けるが、質問にうまく答えるとは限らない |
| ファインチューニング | 人が作った「指示と模範解答」の組 | 指示に答える形で返せる |
| RLHF | 複数の回答に人が付けた評価 | 人が好ましいと感じる答え方に寄る |
この流れは、OpenAIが2022年に発表したInstructGPTの論文で広く知られるようになり、ChatGPTの作り方の土台になりました。
事前学習
事前学習は、LLMが言葉の使い方と幅広い知識を身につける最初の段階です。Webページ・書籍・論文・プログラムなど、膨大な文章を読ませます。
やることは1つだけで、次トークン予測です。文章の途中までを見せて、次に来る語を当てさせます。「吾輩は猫で」まで見せたら「ある」を当てる、という練習を、数兆語ぶんの文章で繰り返します。正解の文章はもとの文章の中にあるので、人が答えを付ける必要がありません。
ここで言う「語」は、正確にはトークンという単位です。トークンは、文章をモデルが扱いやすい大きさに区切った断片で、1単語のこともあれば、単語の一部や1文字のこともあります。区切り方は「生成AIの生成(推論)プロセスと、生成AIが苦手なこと」で扱います。
予測が外れるたびに、モデルの中のパラメータを少しずつ直します。パラメータは、モデルの中にある調整用の数値のことで、大きなLLMでは数千億個に及ぶとされています。次トークン予測を大量に繰り返すうちに、文法だけでなく、事実の知識や文章の組み立て方もパラメータの中に蓄えられていきます。
ただし、事前学習で身につくのは「もっともらしい続きを書く力」です。事実かどうかを確かめる仕組みは入っていません。学習データに無いことを聞かれても、それらしい続きを作ってしまいます。これがハルシネーション(事実と違う内容をもっともらしく出力すること)の一因です。生成のときに何が起きているかは「生成AIの生成(推論)プロセスと、生成AIが苦手なこと」で扱います。
ファインチューニング
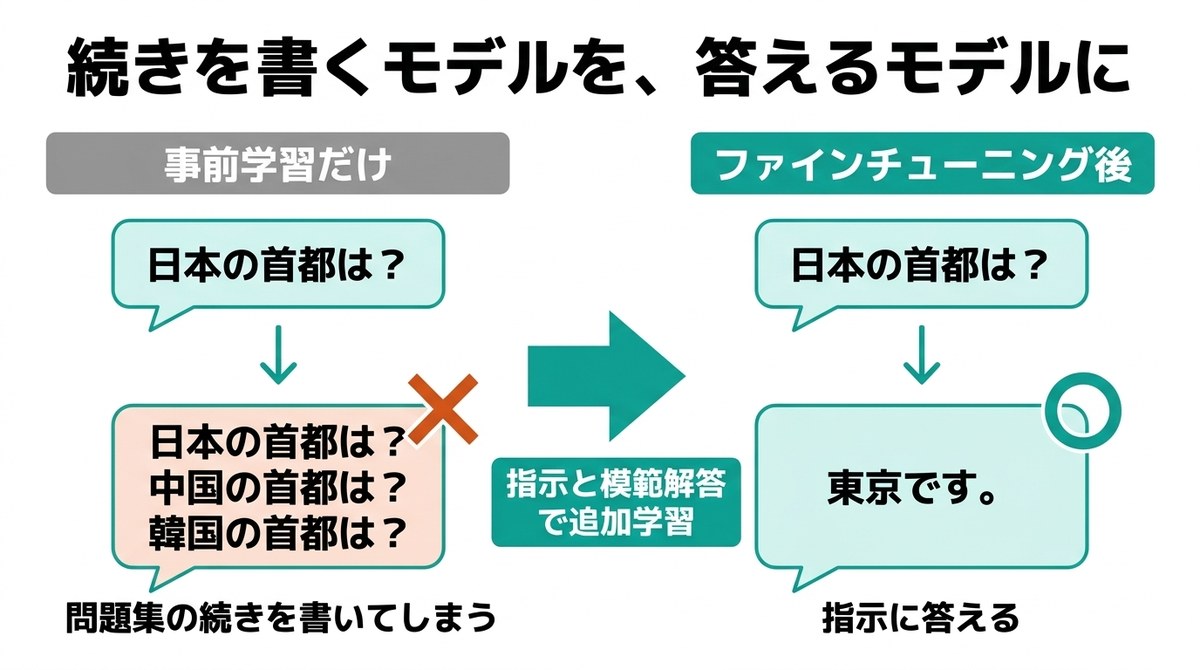
事前学習を終えたモデルに「日本の首都は?」と入力しても、「日本の首都は? 中国の首都は?」のように問題集の続きを書いてしまうことがあります。続きを書くことしか学んでいないからです。
そこで、すでに学習したモデルに、目的に合った少量のデータで追加の学習をさせます。これをファインチューニング(微調整)と呼びます。いちから作り直すのではなく、事前学習で得た力を土台にして調整するので、少ないデータと計算で済みます。
教師ありファインチューニングと指示チューニング
対話AIを作るときによく使うのが、教師ありファインチューニングです。人が「指示」と「模範解答」の組を用意し、模範解答どおりに答えられるように学習させます。
例:指示「次の文を一文で要約して」+元の文章 → 模範解答「〜です。」
このように、さまざまな種類の指示とその答え方を学ばせることを指示チューニング(Instruction Tuning)と呼びます。要約・翻訳・説明・分類など、多くの種類の指示で学習させると、学習で見ていない新しい指示にも答えやすくなります。
ドメイン適応と追加学習
ファインチューニングは、特定の分野に強くするためにも使います。医療・法律・社内の業務文書のように、専門の言葉が多い分野の文章で学習させることをドメイン適応と呼びます。
このように、できあがったモデルにあとからデータを足して学習させることを、広く追加学習と呼びます。ただし、追加学習は手間と費用がかかり、最新の情報を入れるたびに学習し直すのは現実的ではありません。社内文書や最新の情報を答えに反映させたいときは、学習させずに検索結果を渡すRAGを使うことが多くなっています(「RAG(検索拡張生成)とは?仕組み・発展形・ユースケース」)。
RLHF(人間のフィードバックによる強化学習)
模範解答をまねるだけでは、「どちらの答えのほうが良いか」という細かな好みまでは身につきません。そこで最後に行うのがRLHF(人間のフィードバックによる強化学習)です。英語のReinforcement Learning from Human Feedbackの略です。
流れは次のとおりです。
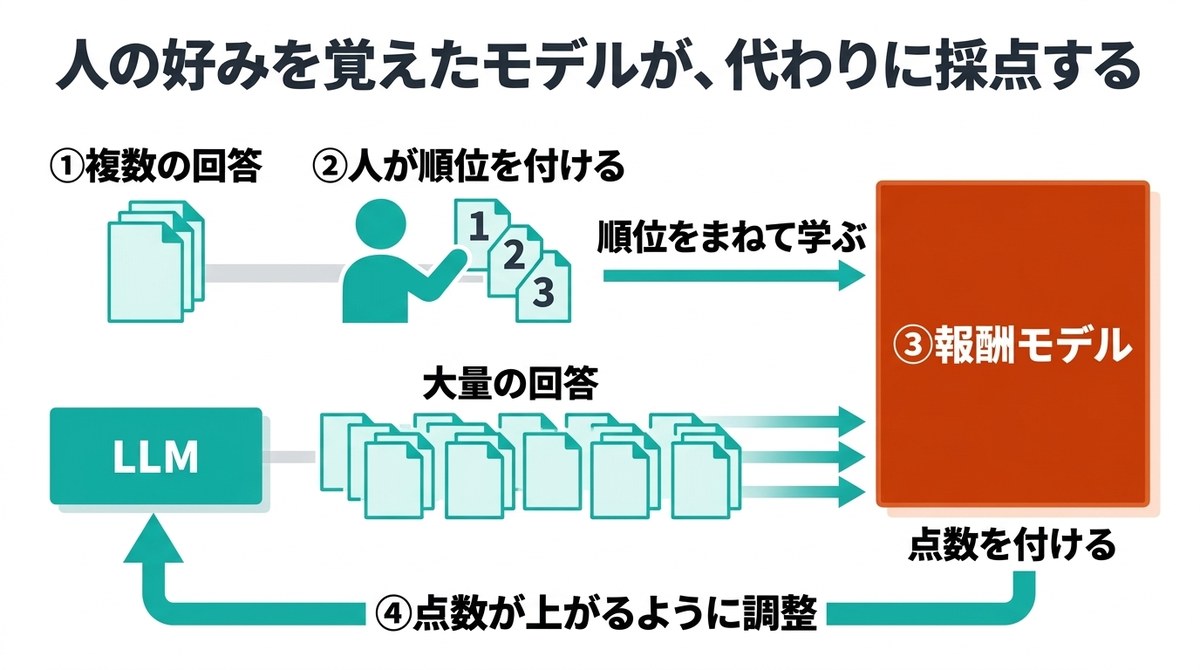
- 同じ質問に対して、モデルに複数の回答を作らせる
- 人がそれらを読み比べ、「AよりBのほうが良い」と順位を付ける(人間の評価)
- その順位をまねて点数を付けるモデルを学習させる。これを報酬モデルと呼ぶ
- 報酬モデルの点数が高くなるように、LLMを強化学習(良い結果に報酬を与えて行動を学ばせる方法)で調整する
人がすべての回答に点数を付けるのは無理なので、人の好みを報酬モデルに覚えさせ、その報酬モデルが代わりに大量の採点をします。役に立つこと、有害な内容を出さないこと、分からないときに分からないと言うことなど、人が良いと考える答え方に近づけるのが目的です。
RLHFにも限界があります。評価する人の好みや偏りは、そのまま報酬モデルに入ります。また、報酬モデルは「人が良いと感じる見た目」を評価するので、自信のある言い方の誤りが高く評価されてしまうことがあります。
スケーリング則と創発的能力
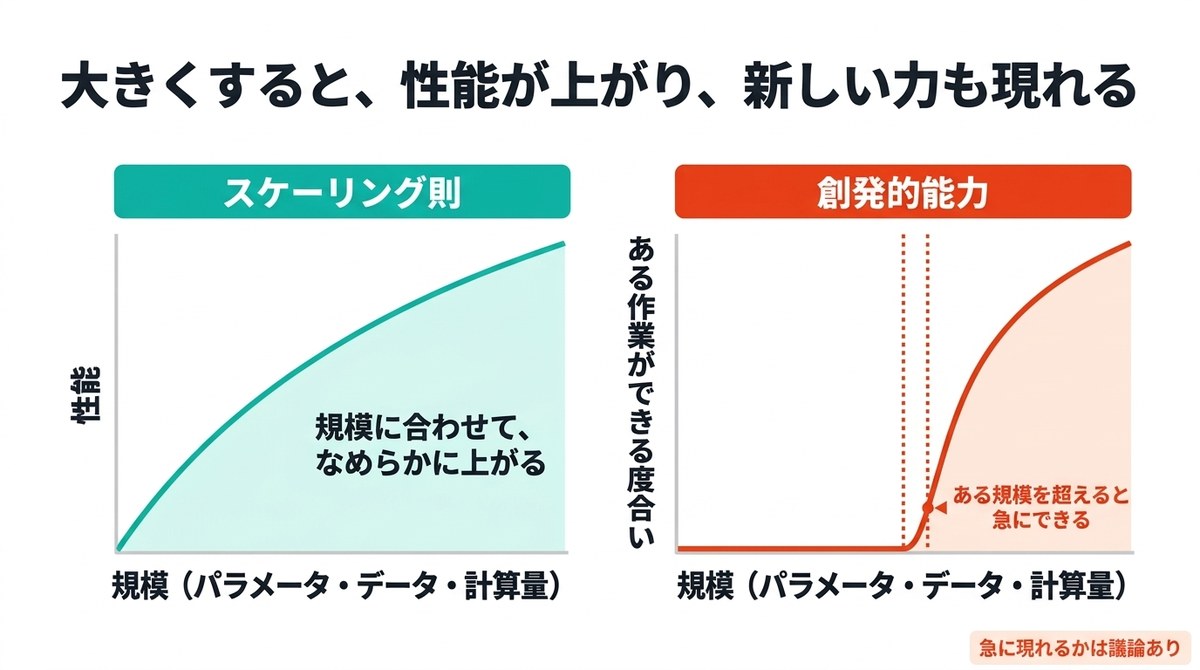
スケーリング則(Scaling Laws)は、モデルのパラメータ数・学習データの量・学習に使う計算量を増やすほど、モデルの性能(予測の誤りの少なさ)が予測できる形で上がっていく、という経験則です。2020年にOpenAIの研究者らが論文で示しました。
この法則が示されたことで、「大きくすれば性能が上がる」と見込んで巨額の投資をする根拠ができ、GPT-3以降のモデルの大型化が進みました。
大型化の中で注目されたのが創発的能力です。小さなモデルではほとんどできなかったことが、ある規模を超えると急にできるようになる現象を指します。たとえば、数段階の計算を順に進める問題や、数例を見せただけで新しい作業をこなす力が、規模を大きくしたモデルで目立つようになったと報告されました。
ただし、創発的能力が本当に「急に」現れるのかについては、測り方によって見え方が変わるという指摘もあり、研究者のあいだで議論が続いています。試験では「規模が大きくなると、小さなモデルには無かった能力が現れることがある」という理解で押さえておくとよいでしょう。
学習データの規模と課題
スケーリング則に従ってモデルを大きくするには、それに見合う量の学習データが要ります。いまのLLMは、インターネット上の文章を中心に、数兆トークン規模のデータで学習しているとされています。量が増えるほど、中身の課題も大きくなります。
データの品質
Web上の文章には、誤った情報、重複、意味をなさない文字列、広告などが多く混じっています。データの品質が低いと、モデルは誤りや雑な文章もそのまま学びます。そのため開発元は、重複や有害な内容を取り除く選別に大きな手間をかけています。量だけでなく、質の高いデータを選ぶことが性能を左右します。
バイアス
学習データに含まれる偏りをバイアスと呼びます。たとえば「医師」と書かれた文章に男性の登場人物が多ければ、モデルも医師を男性として書きやすくなります。特定の国や言語の文章が多ければ、その文化の見方に寄った答えになります。学習データのバイアスは、ファインチューニングやRLHFで和らげることはできても、完全には取り除けません。
著作権
学習データには、他人が書いた文章や描いた画像が大量に含まれます。そのため、学習に使うことや、学習したモデルが元の作品に似たものを出力することについて、著作権の問題が議論されています。日本の著作権法には、AIの学習のような情報解析のための利用を一定の条件のもとで認める規定(第30条の4)がありますが、権利者の利益を不当に害する場合は対象外になります。生成物の扱いも含めて「AIと著作権・肖像権(著作権・知的財産・生成物の権利)」で扱います。
この単元のまとめ
- LLMは、事前学習 → ファインチューニング → RLHFの3段階で作られる
- 事前学習は、膨大な文章で次トークン予測を繰り返し、パラメータに言葉と知識を蓄える。事実を確かめる仕組みは無く、ハルシネーションの一因になる
- ファインチューニングは、学習済みのモデルを少量のデータで調整する。指示チューニングで指示に答える形を学び、ドメイン適応で特定分野に強くする
- RLHFは、人間の評価から報酬モデルを作り、その点数が高くなるようにモデルを調整する
- スケーリング則は「規模を大きくすると性能が上がる」という経験則。学習データには品質・バイアス・著作権の課題がある
この単元の問題9問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
生成AIの単元
- 2-1生成AIを支える技術革新(Transformer・GPT・拡散モデル)
- 2-2生成AIの学習プロセス(事前学習・ファインチューニング・RLHF)いま読んでいるページ
- 2-3生成AIの生成(推論)プロセスと、生成AIが苦手なこと
- 2-4LMとLLMの違い(LLM・大規模言語モデルの基礎)
- 2-5ChatGPTと主要な生成AI(Gemini・Claude・Copilot)の動向
- 2-6各モダリティの生成AI(画像・音楽・音声・動画)
