 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
この記事では、文章以外のデータを作る生成AIを、画像・音楽・音声・動画の順に扱います。それぞれについて、仕組み、主なツール、どんな場面で使われているか、使うときに何に気をつけるかを見ていきます。
文章・画像・音声・動画のような、データの種類のことをモダリティと呼びます(「生成AIを支える技術革新(Transformer・GPT・拡散モデル)」)。文章の生成AIの仕組みは「生成AIの生成(推論)プロセスと、生成AIが苦手なこと」、ChatGPTなどの対話サービスは「ChatGPTと主要な生成AI(Gemini・Claude・Copilot)の動向」で扱っています。ツールの名前は入れかわりが速いので、この記事の情報は2026年11月時点のものです。
この単元を講義動画で見るIT資格の森の会員向け
講義2-6「各モダリティの生成AI」(11分01秒)。この単元の内容を、動く図解で約11分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(2-1「生成AIを支える技術革新」)。(IT資格の森とUdemyの違い・料金)
画像生成AI
画像生成AIは、「夕焼けの海辺を歩く柴犬、水彩画風」のような文章の指示(プロンプト)から、画像を作るAIです。写真のような画像から、イラスト、ロゴの案、商品の背景まで作れます。
仕組み:拡散モデル
いまの画像生成AIの多くは、拡散モデルという仕組みを使っています。学習では、画像に少しずつノイズを足していき、足されたノイズを当てる練習を大量に繰り返します。生成では、砂嵐のようなノイズから出発し、プロンプトの内容に合う方向へノイズを少しずつ取り除いて画像を浮かび上がらせます。詳しくは「生成AIを支える技術革新(Transformer・GPT・拡散モデル)」で扱っています。
主なツールには、Stable Diffusion(Stability AI。モデルが公開されていて自分の環境でも動かせる)、Midjourney、ChatGPTの画像生成、GoogleのGemini、AdobeのFireflyなどがあります。
インペインティング
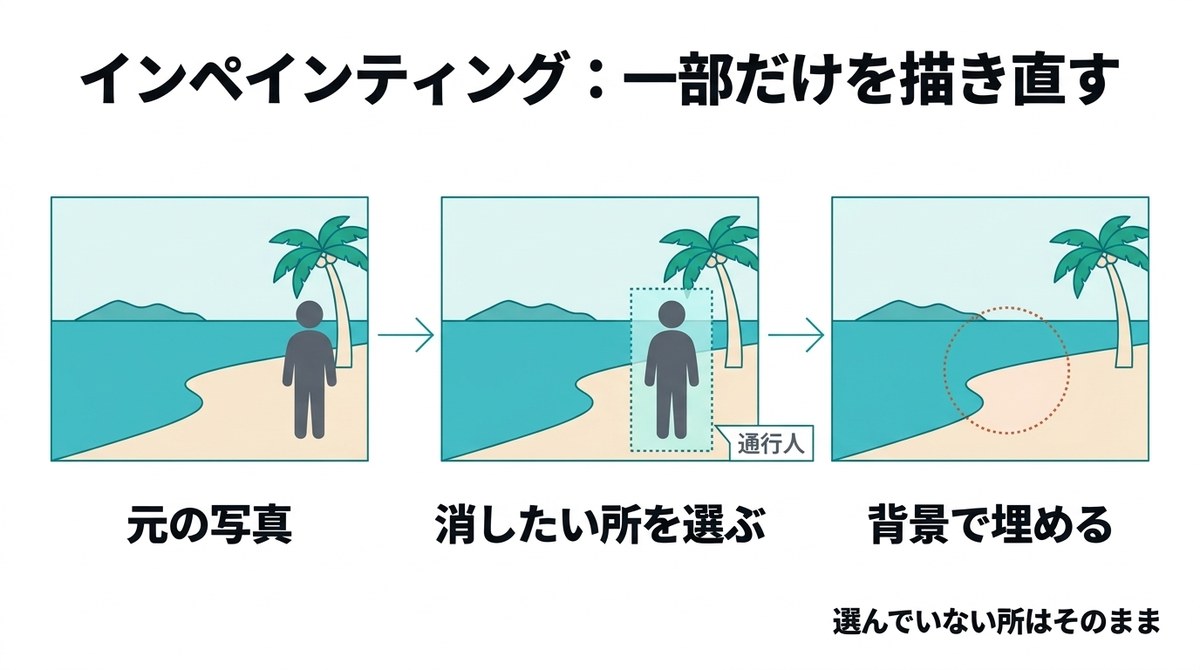
画像の一部だけを選んで、そこを描き直させる機能をインペインティングと呼びます。写真に写り込んだ通行人を消して背景で埋める、商品写真の背景だけを別の景色にする、といった使い方をします。逆に、画像の外側を描き足して、画面を広げる機能もあります。
活用事例と注意点
広告やWebサイトのイメージ画像、企画会議用の完成イメージ、資料の挿絵などに使われています。何十案も短時間で出せるので、方向性を決める段階で特に役立ちます。
注意点は、特定の作家の作風や既存のキャラクターに似た画像ができてしまうことがある点です。そのまま公開・販売すると、著作権や商標の問題になるおそれがあります(「AIと著作権・肖像権(著作権・知的財産・生成物の権利)」)。また、手の指の本数や文字など、細部が崩れることもあるので、使う前に人が確かめます。
電子透かし・来歴情報・C2PA
生成AIの画像は本物の写真と見分けにくいため、「AIで作られた」ことを後から確かめられるようにする技術が広がっています。
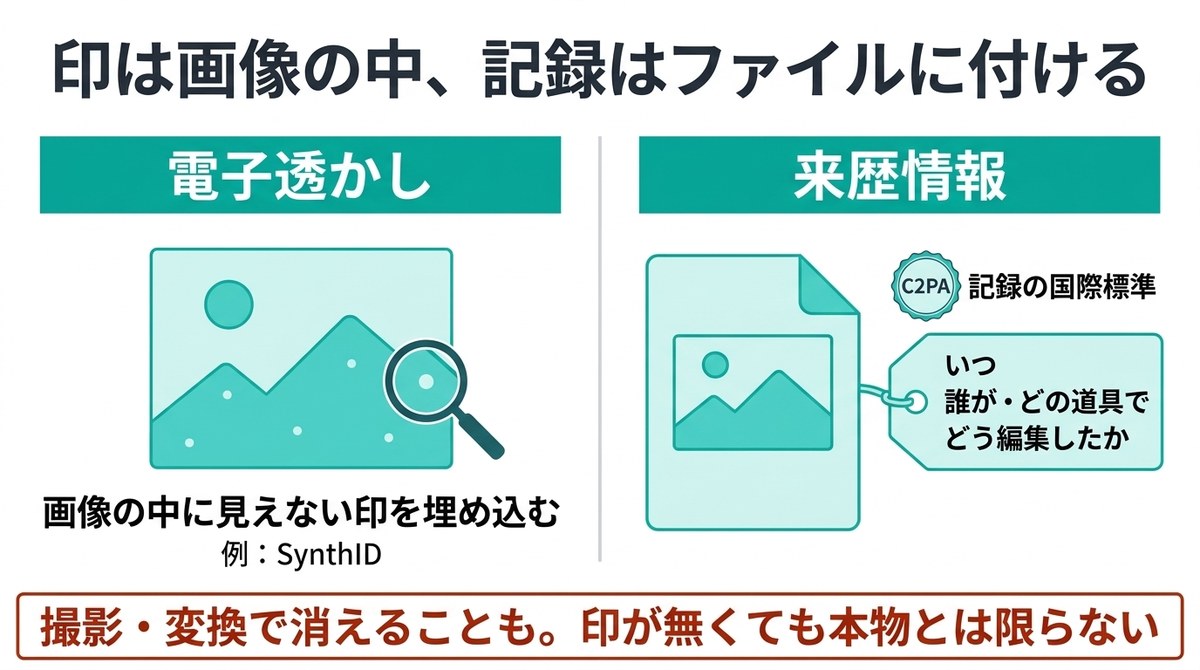
- 電子透かし:画像そのものに、人の目には見えない印を埋め込む技術。画像が加工されても残りやすいように作られる。Googleの「SynthID」などがある
- 来歴情報:いつ、誰が、どの道具で作り、どう編集したかの記録。画像ファイルに付けて、あとから確かめられるようにする
- C2PA:来歴情報をファイルに付けるための国際的な技術標準。Adobe・Microsoft・Googleなどが参加する団体が定めている。C2PAに沿った来歴情報は「コンテンツクレデンシャル」とも呼ばれる
ただし、来歴情報は画面の撮影やファイルの変換で消えることがあります。「印が無いから本物」とは言い切れない点に注意が要ります。
音楽生成AI
音楽生成AIは、「明るいポップス、夏の海、女性ボーカル」のような指示から、曲を作るAIです。伴奏だけでなく、歌詞を入れると歌声つきの曲まで作れるサービスがあります。主なツールには、Suno、Udioなどがあります。
仕組みは、音を短い区切りのデータにして、画像と同じように拡散モデルで作る方法や、文章の生成AIと同じように音の断片を順に予測して並べる方法があります。
動画のBGM、店内で流す音楽、ゲームの効果音、作曲の下書きなどに使われています。
注意点は、既存の曲や特定の歌手の歌い方に似た曲ができることがある点です。音楽生成AIの学習に既存の曲が使われたとして、レコード会社が提供元を訴えた例もあります。商用で使うときは、サービスの利用規約で商用利用が認められているかと、生成した曲の権利が誰にあるかを確かめます。
音声生成AI
音声生成AIは、文章を人の声で読み上げたり、特定の人の声を再現したりするAIです。主なツールには、ElevenLabs、各社のクラウドの読み上げサービス、ChatGPTやGeminiの音声会話機能などがあります。
ニューラルTTS
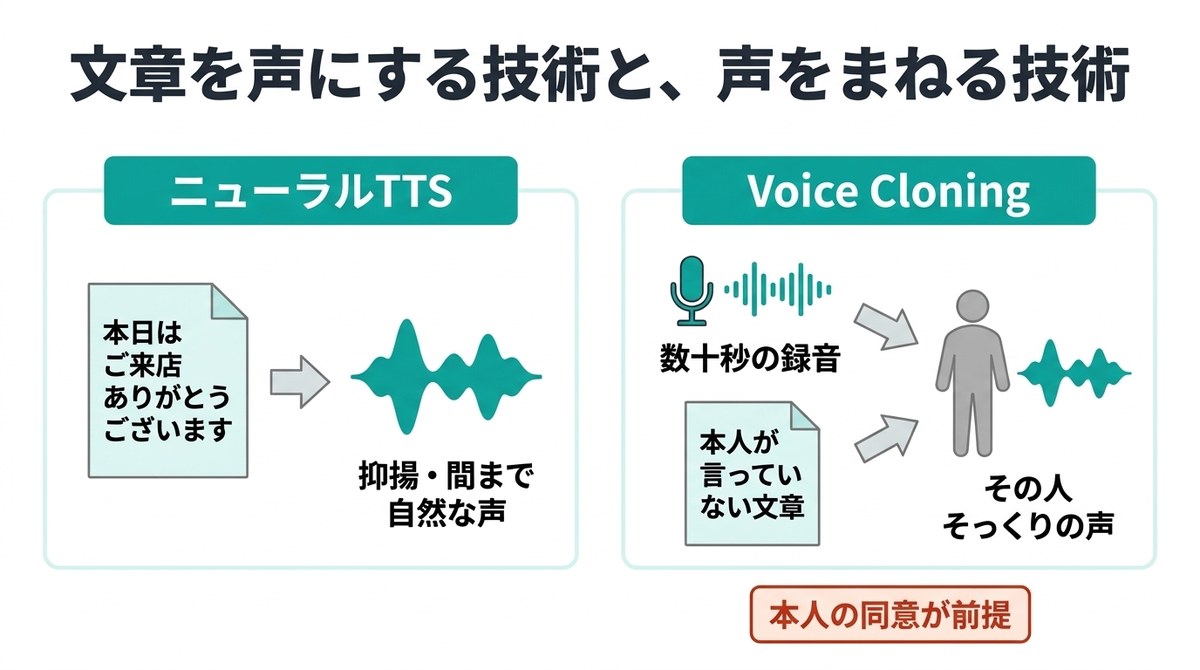
文章を音声に変える技術をTTS(Text-to-Speech、音声合成)と呼びます。ニューラルネットワークを使って、抑揚や間の取り方まで人に近い声を作るものをニューラルTTS(Text-to-Speech)と呼びます。以前の読み上げは、録音した音の断片をつなぐ方式が中心で、機械的な声になりがちでした。ニューラルTTSでは、うれしそうに、落ち着いて、といった話し方の調子も指定できます。
Voice Cloning
短い録音から、特定の人の声の特徴を学ばせて、その人が言っていない文章をその人の声で話させる技術をVoice Cloning(声のクローン)と呼びます。数十秒〜数分の録音で、かなり似た声を作れるものもあります。
活用事例と注意点
動画のナレーション、電話の自動応答、オーディオブック、病気で声を失う人が自分の声を残す用途、話者の声のまま他の言語に吹き替える用途などに使われています。
一方で、Voice Cloningは悪用されると深刻な被害につながります。家族や会社の上司の声をまねて電話をかけ、送金させる詐欺が海外で報告されています。他人の声を再現するときは、本人の同意を得ることが前提です。主要なサービスの多くも、声の持ち主本人の同意を利用条件にしています。声を使ったなりすましへの備えは「生成AIの代表的リスク(ディープフェイク・フィッシング・マルウェア・ソーシャルエンジニアリング)」で扱います。
動画生成AI
動画生成AIは、文章の指示や1枚の画像から、数秒〜数十秒ほどの動画を作るAIです。主なツールには、GoogleのVeo、Runwayなどがあります。最近は、映像に合わせて効果音やせりふの音声まで同時に作るものも出ています。
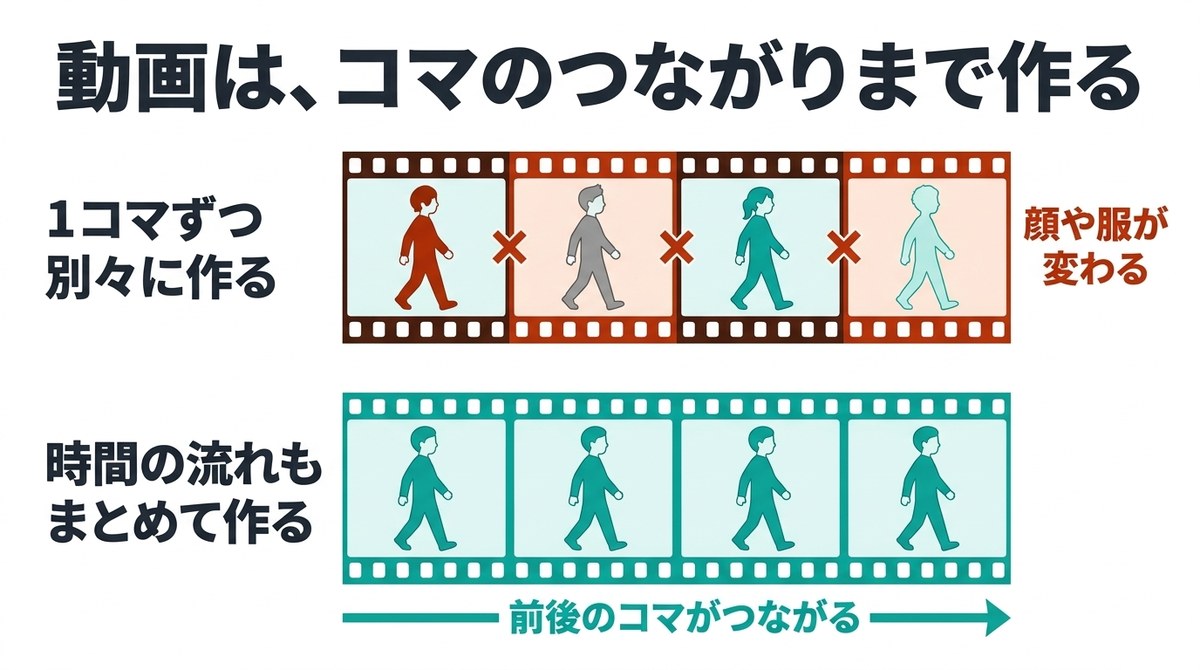
仕組みは画像生成AIの延長で、拡散モデルを使うものが中心です。ただし動画では、1枚ずつ別々に作ると、コマごとに人の顔や服が変わってしまいます。そこで、時間の流れも含めてまとめて扱い、前後のコマで形や動きがつながるように作ります。
広告やSNS用の短い動画、映画やCMの絵コンテ、商品の使い方の説明動画、研修用の動画などに使われています。
ディープフェイク
動画生成AIや顔の入れかえの技術を使って、実在の人が言っていないことを言わせたり、していないことをしている映像を作ったりしたものをディープフェイクと呼びます。音声生成AIと組み合わせると、見た目も声も本人そっくりの映像になります。
政治家の偽の演説動画、有名人を使った投資詐欺の広告、ビデオ会議で上司になりすまして送金を指示する詐欺、本人の同意の無い性的な画像・動画など、実際の被害が出ています。実在の人を映像や音声に登場させるときは本人の同意を得る、公開する動画にはAIで作ったことを明示する、といった配慮が求められます。ディープフェイクによるなりすましのリスクと対策は「生成AIの代表的リスク(ディープフェイク・フィッシング・マルウェア・ソーシャルエンジニアリング)」で扱います。
4つのモダリティを比べる
| 種類 | 主な仕組み | 主なツール(2026年11月時点) | 特に気をつけること |
|---|---|---|---|
| 画像 | 拡散モデル | Stable Diffusion、Midjourney、ChatGPT、Gemini、Firefly | 既存の作品・キャラクターとの類似 |
| 音楽 | 拡散モデル、音の断片の予測 | Suno、Udio | 既存の曲との類似、商用利用の条件 |
| 音声 | ニューラルTTS、Voice Cloning | ElevenLabs、各社の音声機能 | 声のなりすまし、本人の同意 |
| 動画 | 拡散モデル(時間方向のつながりも扱う) | Veo、Runway | ディープフェイク、本人の同意 |
どのモダリティでも共通するのは、本物と見分けにくいものを短時間で作れることです。作る側は、権利と本人の同意を確かめ、AIで作ったことを示す。見る側は、来歴情報を確かめ、出どころの分からない映像や音声をすぐに信じない。この両方の心がけが、各モダリティの生成AIを安全に使う前提になります。
この単元のまとめ
- 画像生成AIは主に拡散モデルで、ノイズを取り除きながら画像を作る。インペインティングで一部だけを描き直せる
- 電子透かしは画像に見えない印を埋め込む技術、来歴情報は作成と編集の記録、C2PAは来歴情報の国際的な技術標準
- 音楽生成AIは指示から歌つきの曲まで作れる。既存曲との類似と商用利用の条件に注意する
- 音声生成AIはニューラルTTSで自然な声を作り、Voice Cloningで特定の人の声を再現できる。他人の声を使うには本人の同意が要る
- 動画生成AIは拡散モデルの延長でコマのつながりも扱う。ディープフェイクによるなりすましに注意する
この単元の問題7問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
生成AIの単元
