 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
この記事では、言語モデル(LM)と大規模言語モデル(LLM)の違いと、LLMをどこで動かすかという選び方を扱います。後半では、自社のサーバーで動かすオンプレミスLLMと、中身が公開されているオープンソースLLMの位置づけを整理します。
この単元を講義動画で見るIT資格の森の会員向け
講義2-4「LMとLLMの違い」(9分51秒)。この単元の内容を、動く図解で約10分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(2-1「生成AIを支える技術革新」)。(IT資格の森とUdemyの違い・料金)
LM(言語モデル)とは
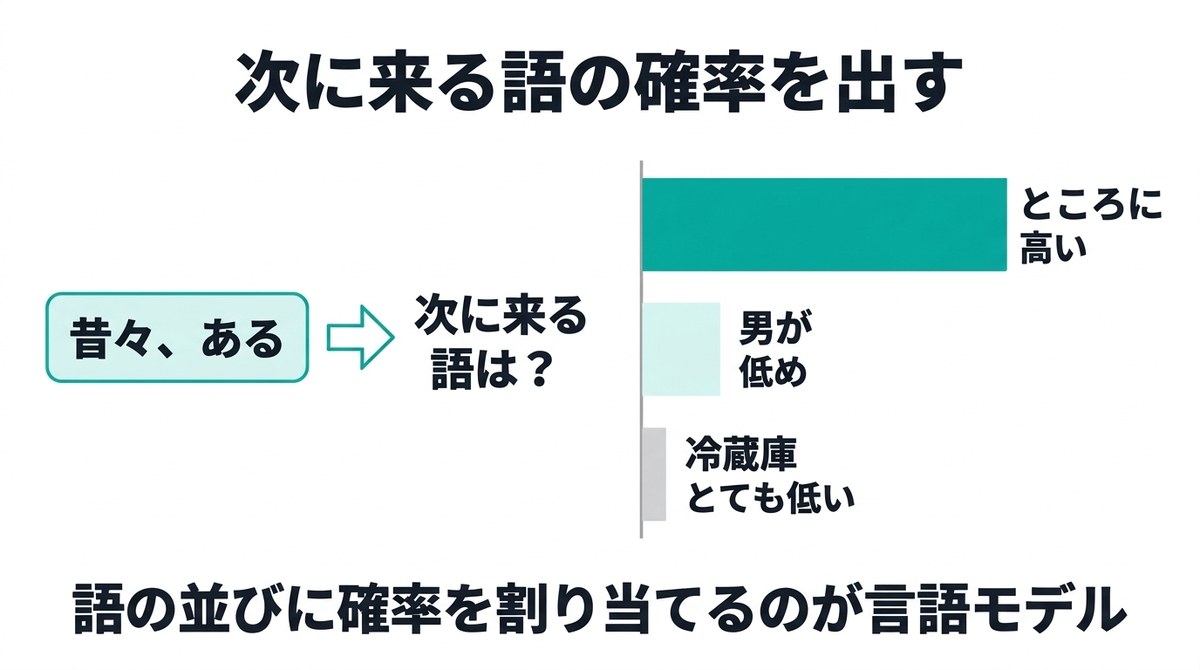
言語モデル(LM:Language Model)は、語の並びに確率を割り当てるモデルです。ある文がどれくらい自然か、次にどの語が来やすいかを、数値で表します。
例:「昔々、ある」の次に来る語
- 「ところに」…確率が高い
- 「男が」…確率は低め
- 「冷蔵庫」…確率はとても低い
言語モデルは、自然言語処理(人間の言葉をコンピュータで扱う分野)の基本の道具です。スマートフォンのキーボードが次の語を候補に出す機能や、音声認識で聞き取りにくい語を文脈から選ぶ機能にも使われてきました。
言語モデルからLLMへ
やがて、ニューラルネットワークを使った言語モデルが登場し、より長い文脈を扱えるようになりました。2017年のTransformer(「生成AIを支える技術革新(Transformer・GPT・拡散モデル)」)によって、さらに長い文脈を速く学習できるようになり、LLMへの道が開けました。
LLM(大規模言語モデル)とは
大規模言語モデル(LLM:Large Language Model)は、Transformerをもとに、パラメータの数・学習データの量・学習に使う計算量を桁違いに大きくした言語モデルです。GPT・Gemini・Claudeなど、いまの対話型の生成AIの中心にあるのがLLMです。
LMとLLMの違いは、規模の大きさだけではありません。規模が大きくなったことで、できることの幅が変わりました。
| 以前の言語モデル | LLM | |
|---|---|---|
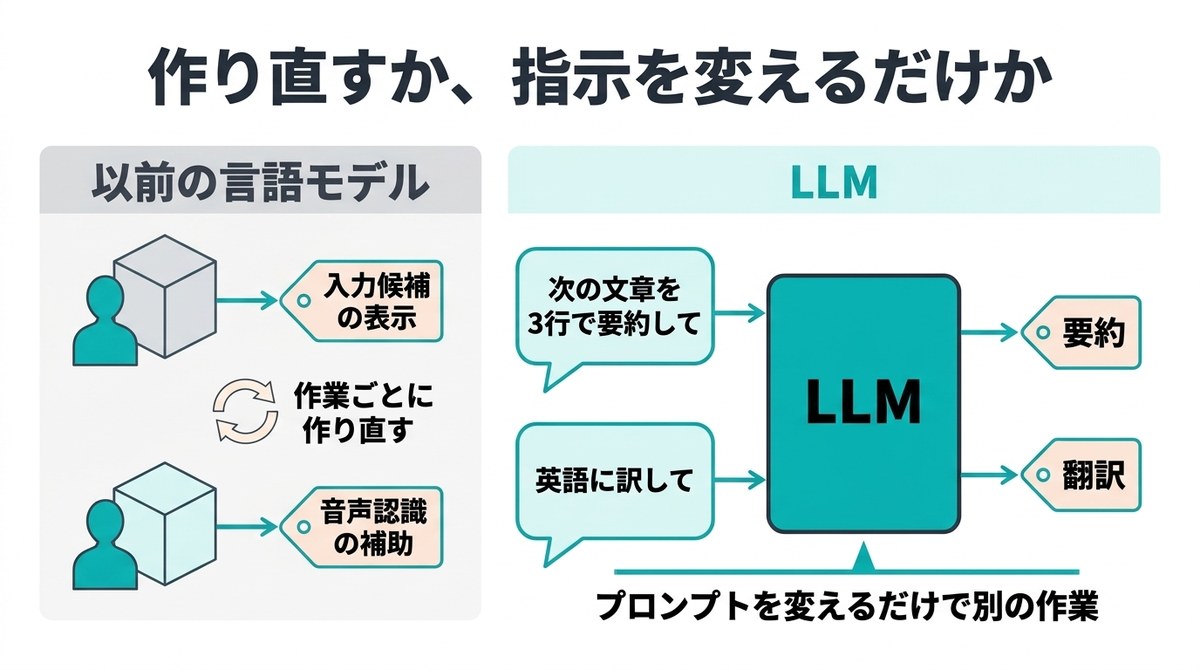
| 主な使われ方 | 入力候補の表示、音声認識の補助など、決まった作業の部品 | 要約・翻訳・質問応答・文章作成・プログラム作成など、1つのモデルで多くの作業 |
| 作業の切り替え | 作業ごとにモデルを作り直す | 指示の文章を変えるだけで、別の作業をさせられる |
| 使う人 | 主に開発者 | 専門知識の無い人も、話し言葉で使える |
創発的能力
規模を大きくする中で、小さなモデルではほとんどできなかった作業が、ある規模を超えるとできるようになる現象が報告されました。これを創発的能力と呼びます。数例を見せただけで新しい作業をこなす、手順を追って推論するといった力が例として挙げられます。どう学習した結果なのかは「生成AIの学習プロセス(事前学習・ファインチューニング・RLHF)」で扱います。
プロンプトで動かす
LLMへの指示や質問の文章をプロンプト(指示文)と呼びます。以前の言語モデルでは、新しい作業をさせるにはデータを集めて学習し直す必要がありました。LLMでは、プロンプトに「次の文章を3行で要約して」と書くだけで要約を、「英語に訳して」と書けば翻訳をしてくれます。
プロンプトの書き方で答えの質が大きく変わるので、書き方の型が研究されています。具体的な書き方は「プロンプトエンジニアリングの基礎(Zero-Shot・Few-Shot・Chain-of-Thought)」で扱います。答えのばらつきを調整するTemperatureなどの設定は「生成AIの生成(推論)プロセスと、生成AIが苦手なこと」で扱います。
クラウド型LLMとオンプレミスLLM
LLMを業務で使うときは、どこでLLMを動かすかを選ぶことになります。
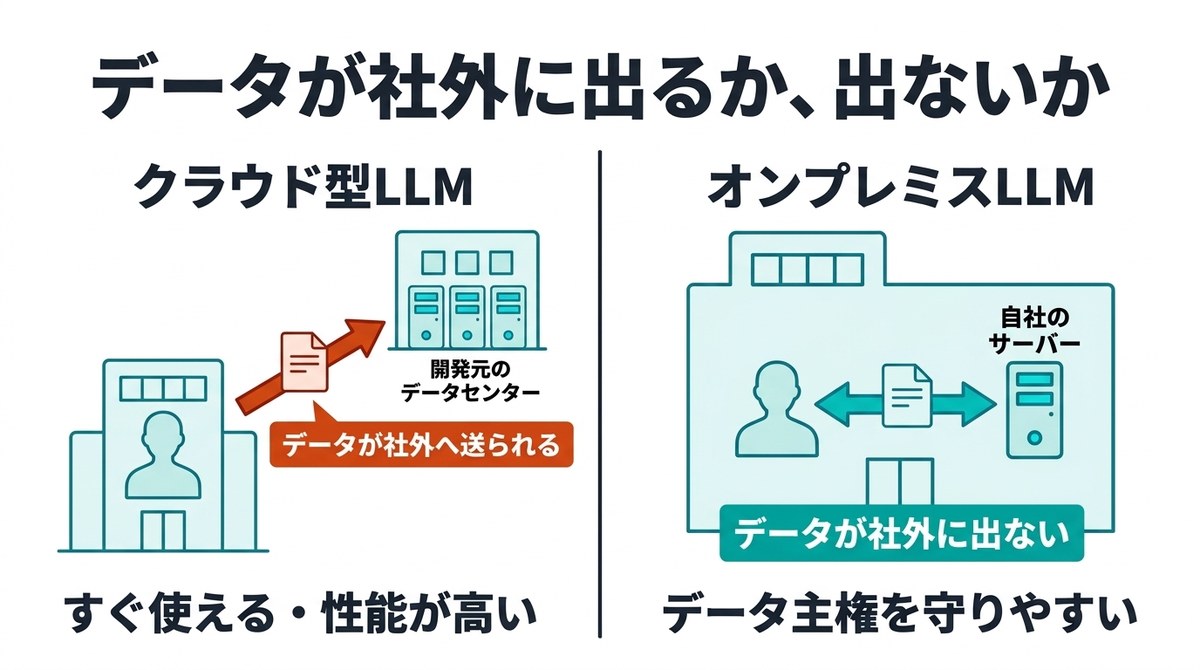
クラウド型LLMは、LLMの開発元などが自社のデータセンターで動かしているLLMを、インターネット経由で使う形です。ChatGPTやGeminiをブラウザで使う、あるいはAPI(プログラムから呼び出す窓口)で使うのがこれにあたります。
オンプレミスLLMは、自社の建物の中や自社が管理するサーバーにLLMを置いて動かす形です。オンプレミスは「自社の敷地内」という意味です。
| クラウド型LLM | オンプレミスLLM | |
|---|---|---|
| 始めやすさ | 契約すればすぐ使える | サーバーやGPUの用意、運用の担当者が要る |
| 性能 | 最新・最大級のモデルを使える | 自社の設備で動く大きさのモデルに限られやすい |
| データの行き先 | 入力したデータが社外のサーバーに送られる | データが社外に出ない |
| 向いている場面 | 一般的な文章作成、社外秘を含まない作業 | 機密情報・個人情報を扱う業務、外部とつながらない環境 |
データ主権
オンプレミスを選ぶ大きな理由がデータ主権です。データを持つ組織や国が、そのデータがどこに置かれ、誰がどう使えるかを自分で決められる状態を指します。クラウド型では、データが海外のデータセンターで処理され、その国の法律の対象になることがあります。医療・金融・行政のように扱うデータが厳しく管理される分野では、データを自社や国内の設備から出さないことが求められる場合があります。
ただし、クラウド型でも、入力したデータを学習に使わない契約や、処理する地域を選べるサービスがあります。どちらが安全かは一律には決まらず、扱うデータと社内の決まりに合わせて選びます。入力してよい情報の考え方は「個人情報保護法と生成AI(個人情報・プライバシー・秘密保持)」で扱います。
オープンソースLLMとオープンウェイト
オンプレミスで動かすには、LLMそのものを手元に置ける必要があります。そこで使われるのが、中身が公開されているLLMです。
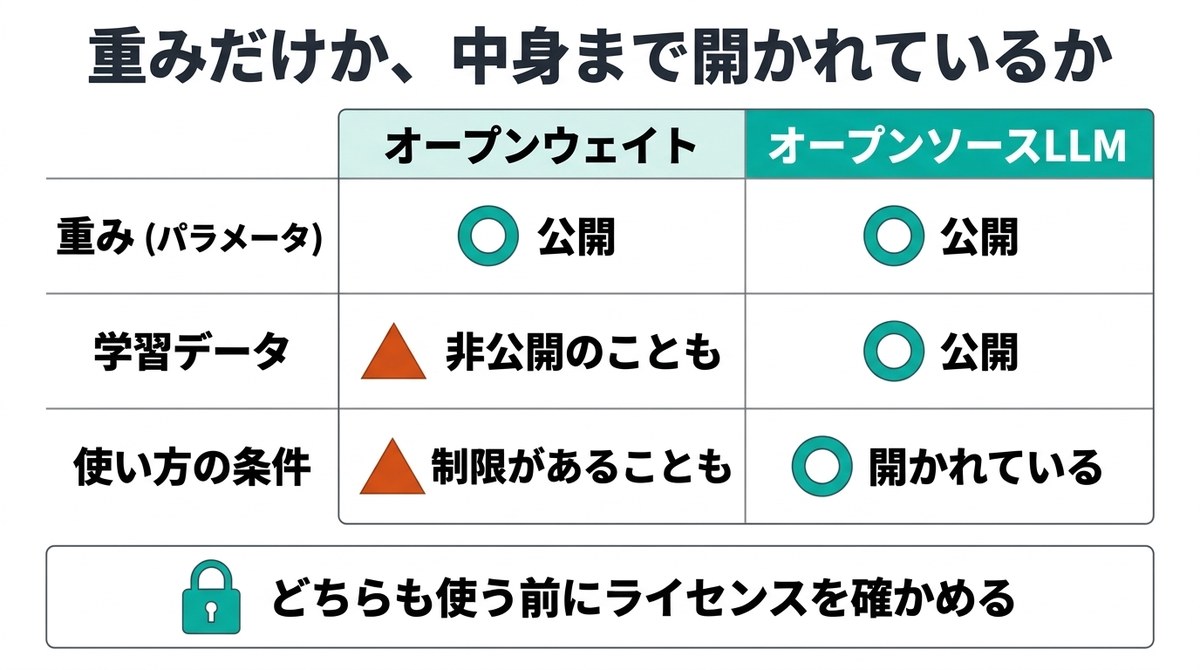
LLMの中身は、学習で決まったパラメータの数値です。これを重み(ウェイト)とも呼びます。重みを公開して、誰でもダウンロードして自分の環境で動かせるようにしたモデルをオープンウェイトのモデルと呼びます。2026年11月時点では、MetaのLlama、OpenAIのgpt-oss、Mistral AIのモデルなどが重みを公開しています。
よく似た言葉にオープンソースLLMがあります。ソフトウェアの世界では、オープンソースは「誰でも使える・中身を調べられる・改変できる・再配布できる」ことを指し、利用目的による差別をしないことも条件に含まれます。LLMでこれにあたるかどうかは、重みだけでなく、学習の方法やデータについての情報が公開されているか、使い方の条件がどうなっているかで決まります。
重みが公開されていても、学習データが非公開だったり、一定の規模を超える企業の利用に条件があったりするモデルもあります。こうしたモデルは、厳密にはオープンソースではなくオープンウェイトと呼び分けられます。ニュースなどでは両方をまとめて「オープンソースLLM」と呼ぶことも多いので、言葉だけで判断しないようにします。
ライセンスを確かめる
オープンウェイトやオープンソースのLLMを使うときに必ず確かめるのがライセンス(使ってよい範囲を定めた利用条件)です。
- 商用で使ってよいか
- 改変したモデルを配布してよいか、そのときに条件はあるか
- 利用者の数や会社の規模に制限はあるか
- 禁止されている用途はあるか
ライセンスはモデルごとに違い、版が変わると条件が変わることもあります。業務で使う前に、提供元が公開しているライセンスの文書を読みます。
オープンなLLMの利点は、データを外に出さずに使えること、自社のデータでファインチューニングして業務に合わせられること、提供元の方針変更やサービス終了の影響を受けにくいことです。一方で、性能の高いモデルほど動かすための設備が大きくなり、安全対策や更新を自社で担う必要があります。
この単元のまとめ
- 言語モデル(LM)は、語の並びに確率を割り当てるモデル。LLMはTransformerをもとに、パラメータ・データ・計算量を桁違いに大きくしたもの
- LLMは創発的能力を持ち、プロンプトを変えるだけで多くの作業をこなせる
- クラウド型LLMはすぐ使えて性能が高い。オンプレミスLLMはデータを社外に出さず、データ主権を守りやすい
- 重みを公開したモデルはオープンウェイト。学習の情報や利用条件まで開かれたものがオープンソースLLM。使う前にライセンスを確かめる
この単元の問題6問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
生成AIの単元

