 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
この記事では、ニューラルネットワークがどうやって学習するのか(重み・損失関数・誤差逆伝播法・勾配降下法)と、過学習を防ぐ工夫、転移学習が分かります。後半では、CNN・RNN・LSTM・VAE・GANという代表的なモデルが何を得意とするかと、識別系AIと生成系AIの違いを整理します。
この単元を講義動画で見るIT資格の森の会員向け
講義1-3「ニューラルネットワーク」(14分00秒)。この単元の内容を、動く図解で約14分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(1-1「AIの基礎」)。(IT資格の森とUdemyの違い・料金)
人間の脳とニューラルネットワーク
人の脳では、たくさんの神経細胞が互いにつながり、信号を受け渡して情報を処理しています。つながりの強い経路ほど、信号がよく伝わります。ニューラルネットワークは、この仕組みを数式でまねた計算の仕組みです。
入力層・隠れ層・出力層
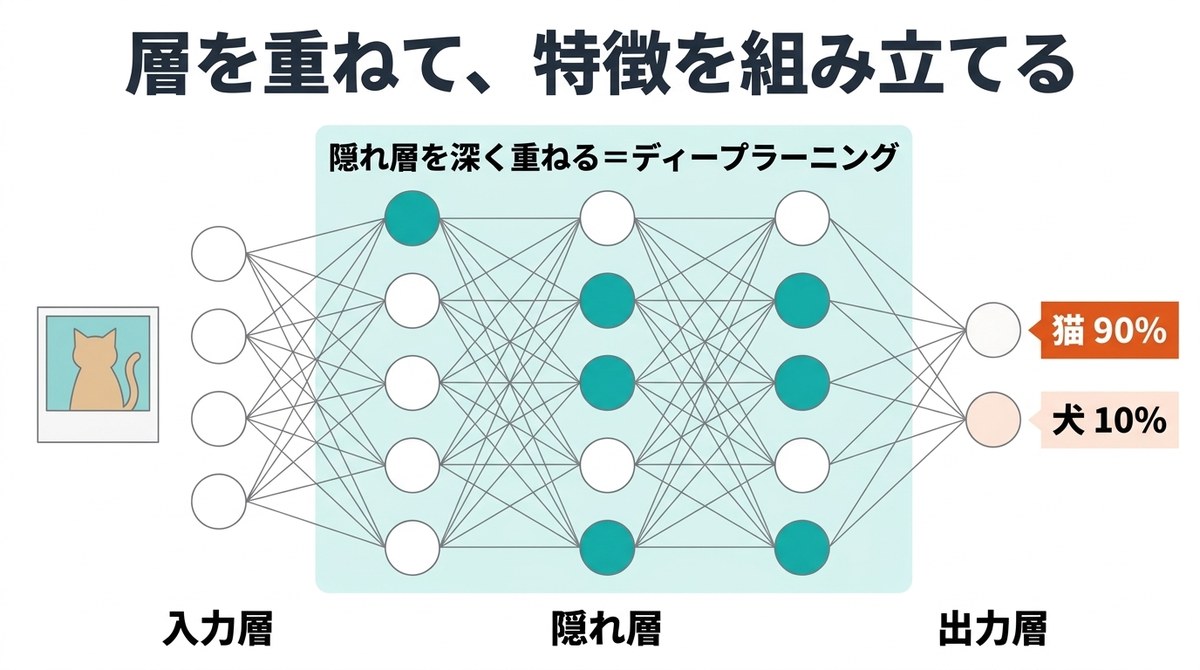
ニューラルネットワークは、数値を受け渡す小さな計算の単位(ノード)を、層の形に並べてつないだものです。層には3つの役割があります。
- 入力層:データを受け取る層。画像なら、ピクセルごとの明るさの数値が入る
- 隠れ層:入力層と出力層の間にある層。受け取った数値を計算して、次の層へ渡す。外からは直接見えないので「隠れ」と呼ぶ
- 出力層:答えを出す層。「猫である確率0.9、犬である確率0.1」のような数値を出す
ディープラーニング(深層学習)
隠れ層を何層にも深く重ねたニューラルネットワークで学習することを、ディープラーニング(深層学習)と呼びます。「ディープ(深い)」は層の深さのことです。
層を重ねると、手前の層は線や角のような単純な特徴をとらえ、奥の層ほど「目」「耳」「顔」のような複雑な特徴を組み立てられるようになります。どこに注目すればよいかを人が決めなくても、データから見つけられるのがディープラーニングの強みです。機械学習との関係は 「AI(人工知能)とは? 定義と2つの仕組み」 を見てください。
重みの調整による学習の仕組み
ニューラルネットワークの「学習」とは、中にある大量の数値を少しずつ直して、正しい答えを出せるようにすることです。直していく数値を重みと呼びます。
重みと活性化関数
重みは、ノードとノードのつながりの強さを表す数値です。ある入力にかかる重みが大きいと、その入力は答えに強く影響します。猫の見分けを学んだネットワークなら、「耳のとがり」につながる重みは大きく、「背景の色」につながる重みは小さくなっていきます。
各ノードは、受け取った数値に重みを掛けて合計し、その結果を活性化関数に通してから次の層へ渡します。活性化関数は、合計した値をどう次に伝えるかを決める関数です。たとえばよく使われるReLUは、マイナスの値は0にして、プラスの値はそのまま通します。活性化関数が無いと、層をいくら重ねても単純な掛け算と足し算の組み合わせにしかならず、複雑なパターンを表せません。
損失関数:答えのズレを1つの数値にする
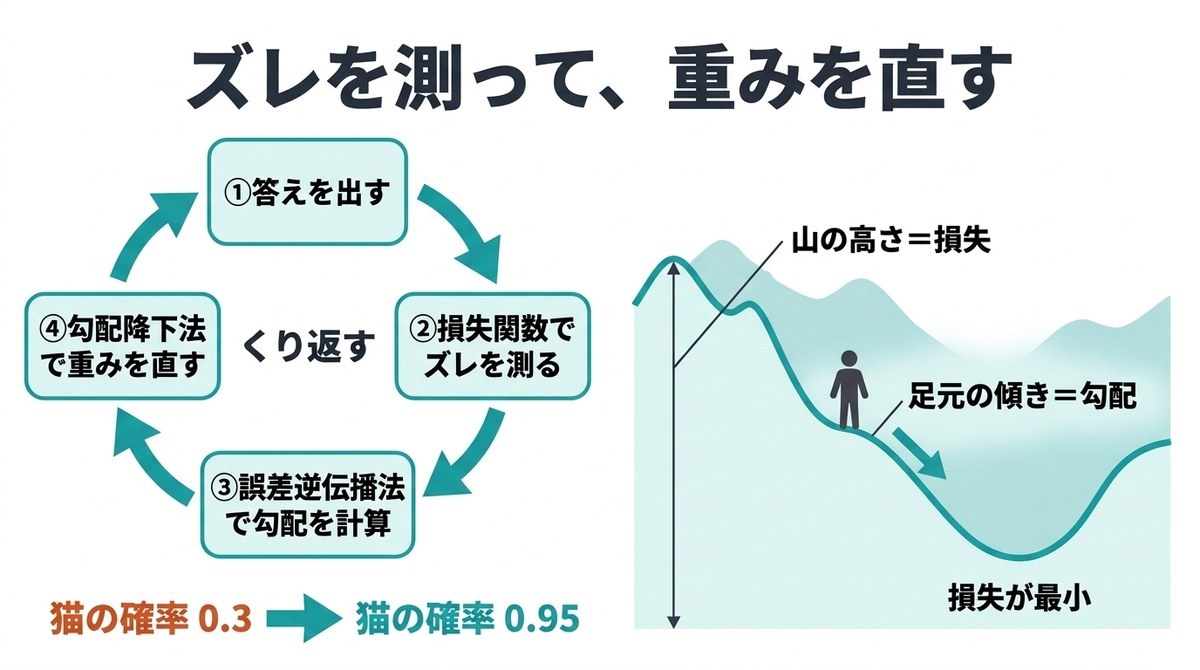
重みを直すには、いまの答えがどれだけ外れているかを数値で知る必要があります。その外れ具合を計算する式を損失関数と呼びます。正解が「猫」なのに「猫である確率0.3」と答えたら損失は大きく、「0.95」と答えたら損失は小さくなります。学習の目標は、この損失を小さくすることです。
誤差逆伝播法と勾配降下法:ズレを減らす方向へ重みを直す
重みは数百万、数十億とあります。どの重みをどちらへどれだけ動かせば損失が減るかを、一つずつ試していては終わりません。
誤差逆伝播法(バックプロパゲーション)は、出力層で出た損失を、出力層から入力層へ向かって逆向きにたどり、それぞれの重みが損失にどれだけ影響したかをまとめて計算する方法です。この「重みを動かしたときに損失がどう変わるか」を表す値を勾配と呼びます。
勾配降下法は、計算した勾配をもとに、損失が下がる方向へ重みを少しずつ動かす方法です。霧の中で山を下りるとき、足元の傾きだけを頼りに、いちばん下っている方向へ一歩ずつ進むのに似ています。山の高さが損失、足元の傾きが勾配です。
学習は、次の流れを何万回もくり返して進みます。
- データを入力して、答えを出す
- 損失関数で、正解とのズレを測る
- 誤差逆伝播法で、重みごとの勾配を計算する
- 勾配降下法で、ズレが減る方向へ重みを少し直す
過学習と対策
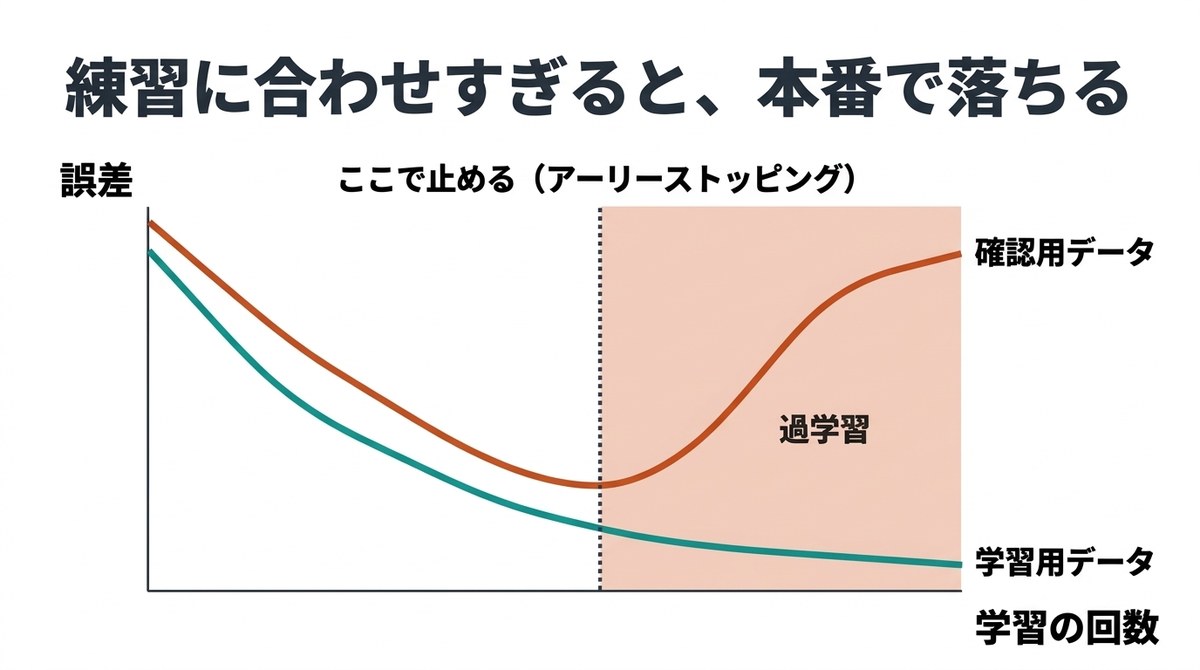
過学習(オーバーフィッティング)は、学習に使ったデータに合わせすぎて、初めて見るデータでは成績が落ちてしまう状態です。練習問題の答えを丸暗記して練習では満点なのに、数字が少し変わった本番の問題が解けない、という状態に似ています。
反対に、初めて見るデータでもよい答えを出せる力を汎化(汎化性能)と呼びます。学習の目的は、手元のデータで満点を取ることではなく、汎化性能を高めることです。過学習を防ぐ代表的な方法は次の3つです。
- アーリーストッピング:学習に使わない確認用のデータで成績を見ながら学習を進め、確認用データでの成績が悪くなり始めたところで学習を止める
- 正則化:重みが極端に大きくならないように、損失関数に罰則の項を加える。モデルが細かい特徴に合わせすぎるのを抑える
- ドロップアウト:学習中に、ノードの一部をランダムに選んで一時的に使わないようにする。特定のノードに頼りすぎず、ネットワーク全体で特徴をとらえるようになる
転移学習とファインチューニング
ディープラーニングは、ゼロから学習させると大量のデータと計算が必要です。そこで、別の作業ですでに学習を終えた学習済みモデルを土台にする方法が使われます。
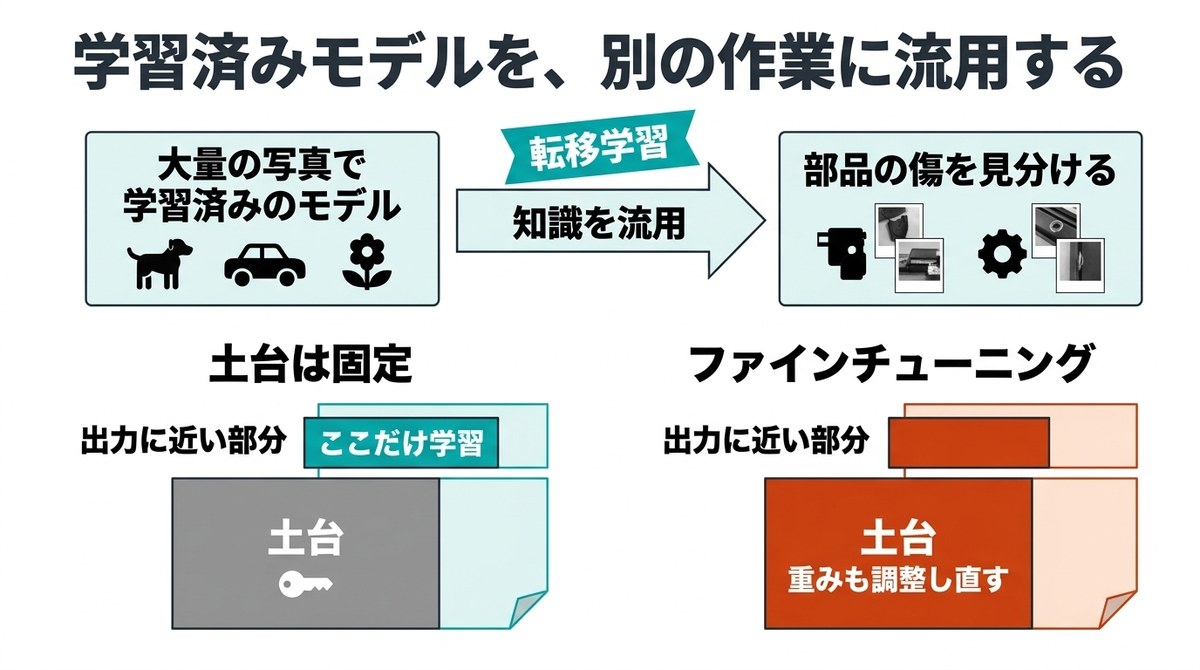
転移学習は、ある作業で学習した学習済みモデルの知識を、別の作業に流用する方法です。たとえば、大量の写真で一般的な物の見分けを学んだモデルは、線や形、模様をとらえる力をすでに持っています。この力を土台にして、工場の部品の傷を見分けるモデルを作れば、少ない部品の写真でも学習できます。
ファインチューニングは、学習済みモデルに新しい作業のデータを追加で学習させ、モデルの重みを新しい作業に合わせて調整し直すことです。転移学習では土台の重みを固定して出力に近い部分だけを学習させる方法もあり、土台の重みまで追加の学習で調整するものをファインチューニングと呼んで区別します。生成AIのファインチューニングは 「生成AIの学習プロセス(事前学習・ファインチューニング・RLHF)」 で扱います。
代表的なモデル:CNN・RNN・LSTM・VAE・GAN
ニューラルネットワークには、扱うデータや目的に合わせた形がいくつもあります。試験では、モデルの名前と「何が得意か」の組み合わせを押さえます。
CNN(畳み込みニューラルネットワーク):画像を見る
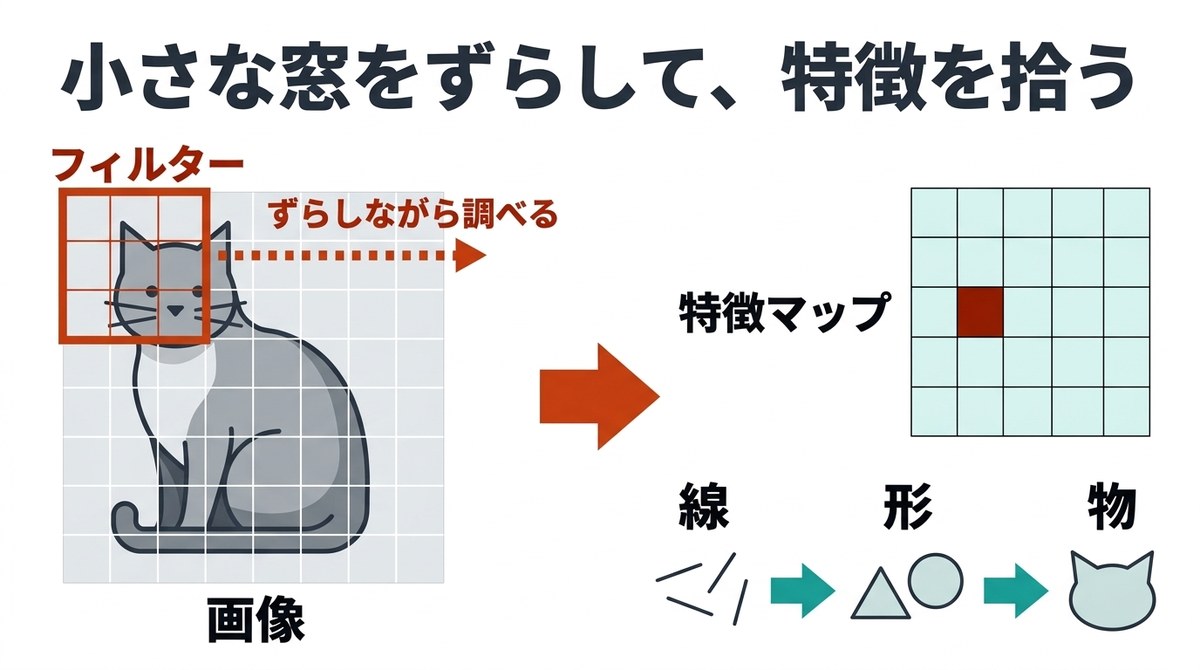
CNNは、画像の認識を得意とするモデルです。画像全体を一度に見るのではなく、小さな窓(フィルター)を少しずつずらしながら画像を調べ、縦線、角、丸みのような部分的な特徴を取り出します。この処理を畳み込みと呼びます。
畳み込みを重ねると、線から形へ、形から「目」や「タイヤ」へと、だんだん大きな特徴を組み立てられます。写真に写った物の判別、顔認証、医療画像の診断支援、自動運転のカメラなど、コンピュータに画像や映像を理解させる分野(コンピュータビジョン)で広く使われてきました。
RNN(再帰型ニューラルネットワーク):順番のあるデータを読む
文章、音声、株価の推移のように、順番に意味があるデータをシーケンスデータと呼びます。「私は 犬が 好き」と「犬は 私が 好き」は単語が同じでも意味が違います。
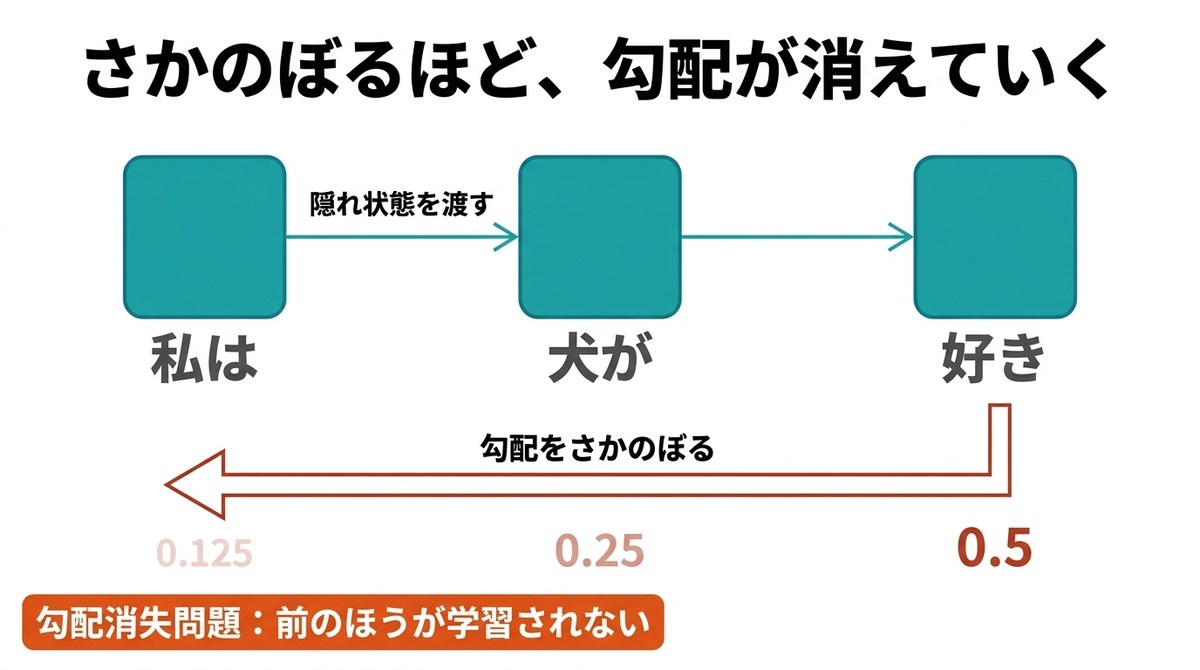
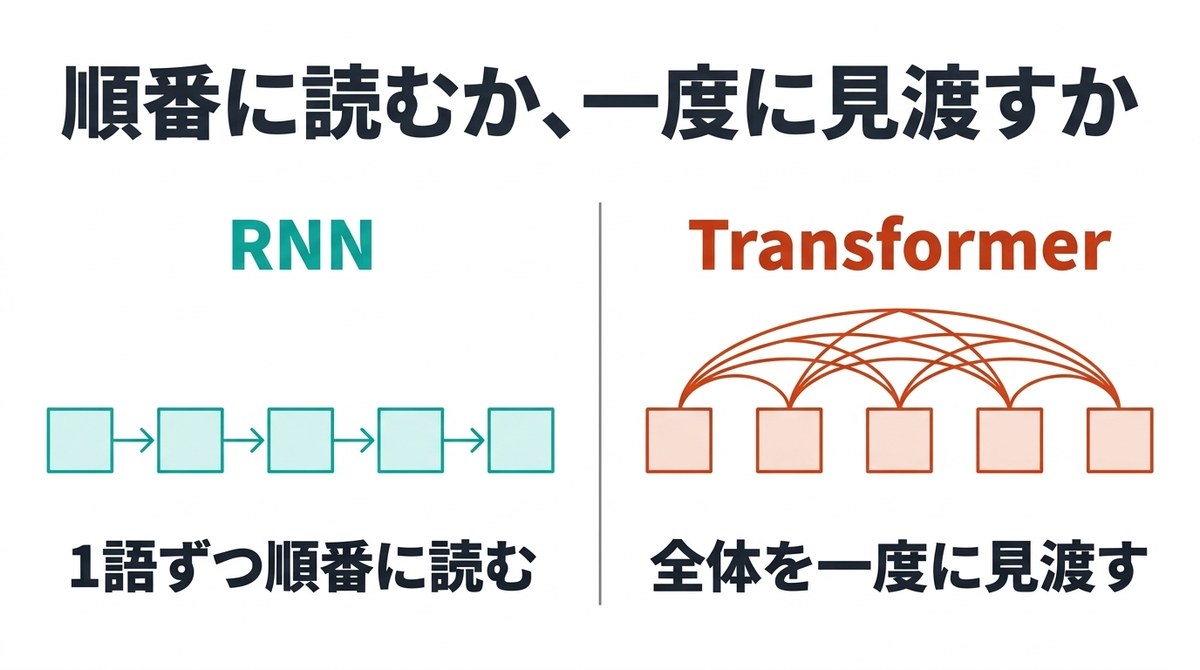
RNN(再帰型ニューラルネットワーク)は、データを1つずつ順に読み、前に読んだ内容を隠れ層の状態として次の計算へ持ち越すモデルです。これで前後の流れを考えた処理ができるようになりました。
ただしRNNには、長いデータを学習しにくいという弱点があります。誤差逆伝播法で勾配を過去へさかのぼって伝えるとき、何度も掛け算をくり返すことになるからです。1より小さい数を何度も掛けると値がほとんど0になり、文の前のほうの内容が学習にほとんど生かされなくなります(RNNは同じ重みをどの時点でも使い回すので、遠い過去からの勾配だけが消えてしまうということです)。これを勾配消失問題と呼びます。逆に1より大きい数を掛け続けると値が膨れ上がり、学習が不安定になります。これが勾配爆発問題です。勾配消失はRNNに限らず、層の深いネットワーク一般で起きます。
LSTM:長い文脈を覚えておく
LSTM(Long Short-Term Memory)は、RNNの勾配消失問題をやわらげるために考えられたモデルです。情報を「どれだけ忘れるか」「どれだけ新しく書き込むか」「どれだけ次に出すか」を調整するゲートという仕組みを持ち、大事な情報を長く保てます。これで、長い文の翻訳や音声認識の精度が上がりました。
その後、離れた位置にある単語同士の関係を直接計算するAttentionという仕組みが考えられ、それを中心に組み立てたTransformerモデルが2017年に発表されました。Transformerは順番に読む必要がなく、今のChatGPTなどの土台になっています。詳しくは 「生成AIを支える技術革新(Transformer・GPT・拡散モデル)」 で扱います。
VAE(変分オートエンコーダ):圧縮してから作り出す
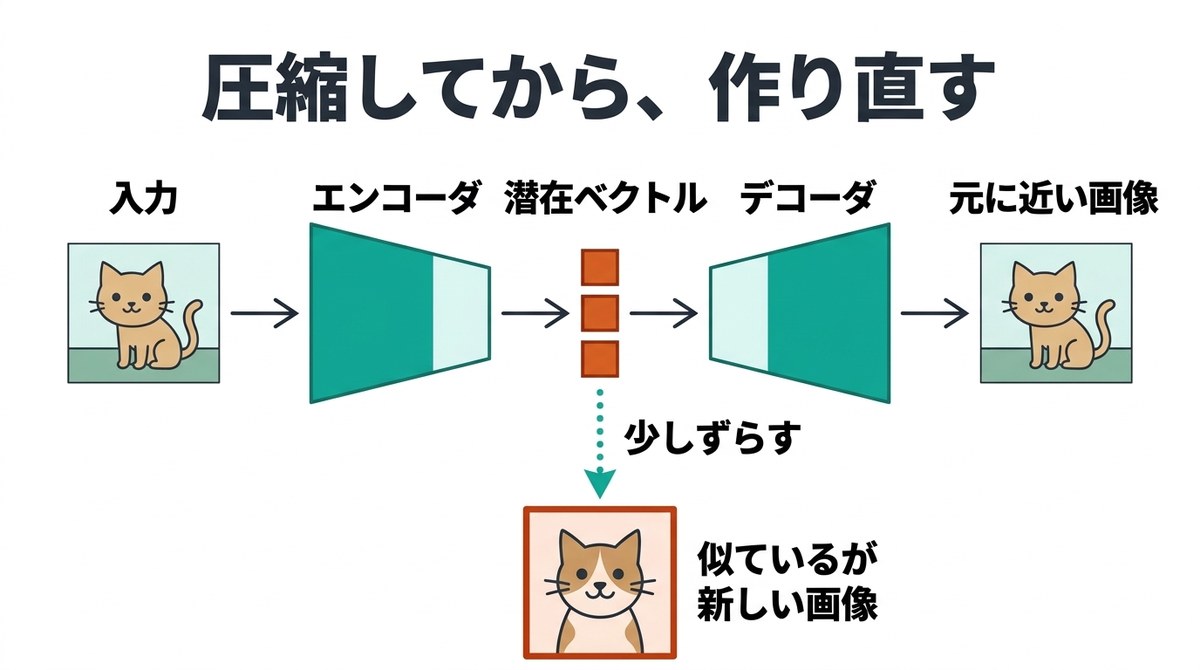
VAE(変分オートエンコーダ)は、新しいデータを作り出す生成のモデルです。2つの部分でできています。
- エンコーダ:画像などの入力を、特徴をまとめた少数の数値に圧縮する。この数値の組を潜在ベクトルと呼ぶ
- デコーダ:潜在ベクトルから、元の画像を組み立て直す
たくさんの数値でできた画像を少数の数値にまとめるので、エンコーダの働きは次元削減(「機械学習とは? 教師あり学習・教師なし学習・強化学習の違い」)と同じ考え方です。VAEは、潜在ベクトルを1点に決めず、ある程度の幅(ばらつき)を持たせて学習します。学習の途中でノイズ(ランダムな値)を加えるのはそのためです。こうしておくと、潜在ベクトルを少しずらしてデコーダに渡すだけで、「学習した画像に似ているけれど、どれとも同じではない画像」を作れます。
GAN(敵対的生成ネットワーク):2つのネットワークを競わせる
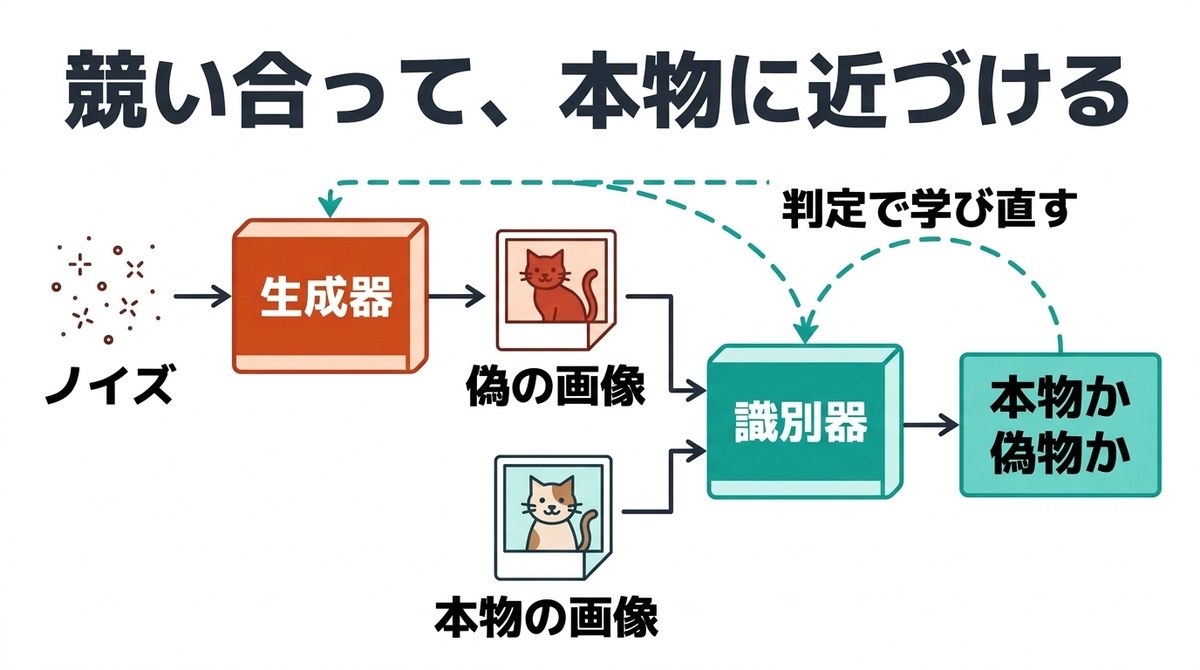
GAN(敵対的生成ネットワーク)は、2つのネットワークを競わせて学習させる生成のモデルです。
- 生成器(Generator):ノイズを受け取って、本物そっくりのデータ(画像など)を作る
- 識別器(Discriminator):渡されたデータが本物か、生成器が作った偽物かを見分ける
生成器は、識別器に偽物だと見抜かれたら作り方を直します。識別器は、偽物を見抜けなかったら見分け方を直します。これをくり返すと、生成器は識別器でも見分けられないほど本物に近いデータを作れるようになります。偽札を作る側と見抜く側が互いに腕を上げていく関係に似ています。
識別系AIと生成系AIの違い
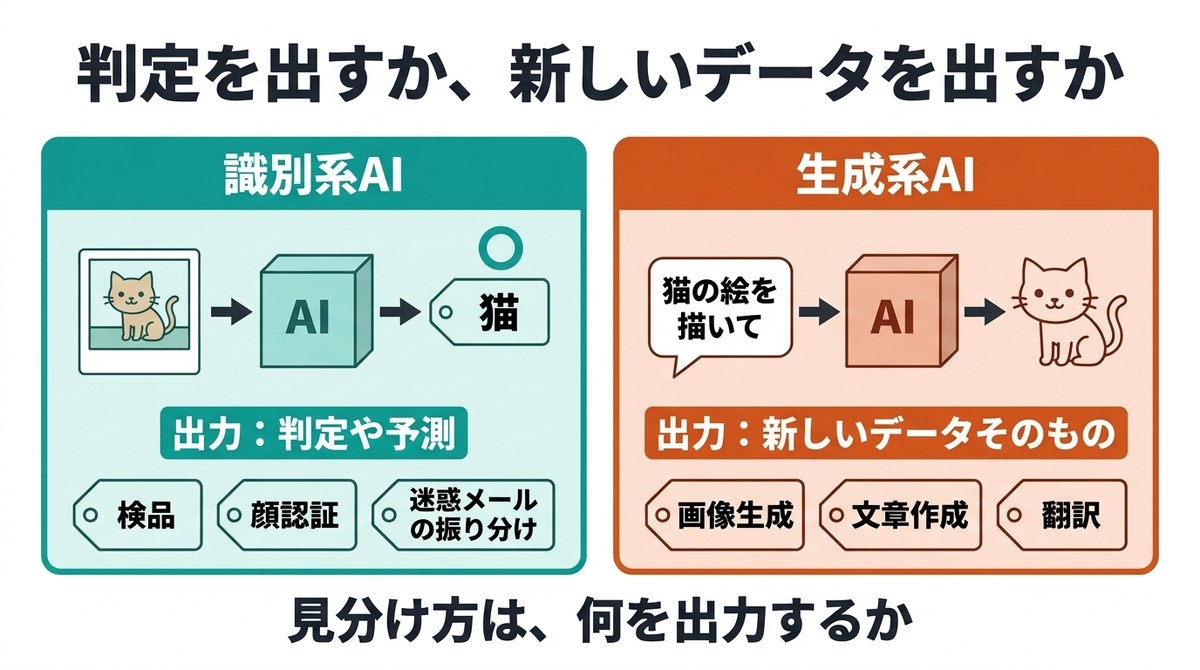
AIは、出力の種類で大きく2つに分けられます。
| 識別系AI | 生成系AI | |
|---|---|---|
| 出力するもの | 入力に対する判定や予測(「猫」「不良品」「来月の売上」) | 新しいデータそのもの(画像・文章・音声) |
| 代表的なモデル | CNNによる画像の判別など | VAE、GAN、Transformerを使ったLLM、拡散モデル |
| 使われ方 | 検品、顔認証、迷惑メールの振り分け | 画像生成、文章作成、要約、翻訳 |
識別系AIは、すでにあるデータを見て「これは何か」を答えます。生成系AIは、学習したデータの特徴をもとに、まだ無いデータを作り出します。同じCNNでも、画像の判別に使えば識別系、生成モデルの部品として使えば生成系の一部になります。モデルの名前よりも「何を出力するか」で見分けるのが確実です。
生成系AIの技術は、本物の人物の顔や声をまねた偽の画像・動画・音声(ディープフェイク)にも使われます。GANはその代表的な技術のひとつです。なりすましなどのリスクと対策は 「生成AIの代表的リスク(ディープフェイク・フィッシング・マルウェア・ソーシャルエンジニアリング)」 で扱います。
この単元のまとめ
- ニューラルネットワークは入力層・隠れ層・出力層からなり、隠れ層を深く重ねて学習するのがディープラーニング
- 学習は、損失関数でズレを測り、誤差逆伝播法で勾配を計算し、勾配降下法で重みを直す、のくり返し
- 過学習は学習データに合わせすぎた状態。アーリーストッピング・正則化・ドロップアウトで防ぎ、汎化性能を高める
- 画像はCNN、シーケンスデータはRNN・LSTM(勾配消失問題をLSTMがやわらげた)、生成はVAE(エンコーダ・デコーダ・潜在ベクトル)とGAN(生成器と識別器)
- 識別系AIは判定や予測を、生成系AIは新しいデータを出力する
この単元の問題15問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
AIの基礎と歴史の単元
- 1-1AI(人工知能)とは? 定義と2つの仕組み
- 1-2機械学習とは? 教師あり学習・教師なし学習・強化学習の違い
- 1-3ニューラルネットワークとディープラーニング(CNN・RNN・VAE・GAN)いま読んでいるページ
- 1-4AIの歴史:3つのブームと冬の時代、生成AI、シンギュラリティ