 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
この記事では、学習を終えた生成AIが、質問を受け取ってから文章を返すまでに中で何をしているかを扱います。この流れを知ると、「400字で書いて」と頼んでも字数がずれる、簡単な計算を間違える、といった生成AIの苦手が、なぜ起きるのかを説明できるようになります。
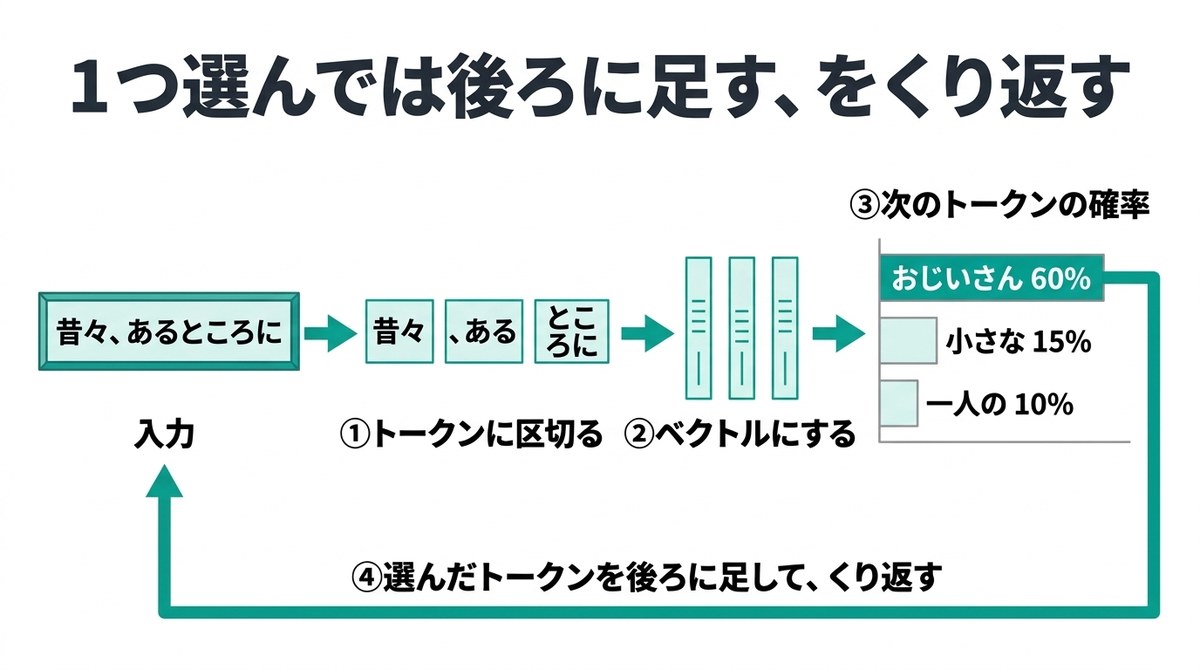
学習済みのモデルを使って答えを出すことを、推論と呼びます。流れは次の順に進みます。
- 入力の文章をトークンに区切る
- トークンを数値の並び(ベクトル)にする
- 次に来るトークンの確率を計算し、1つ選ぶ
- 選んだトークンを入力の後ろに足して、3に戻る
この単元を講義動画で見るIT資格の森の会員向け
講義2-3「生成AIの生成(推論)プロセス」(11分49秒)。この単元の内容を、動く図解で約12分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(2-1「生成AIを支える技術革新」)。(IT資格の森とUdemyの違い・料金)
トークン化
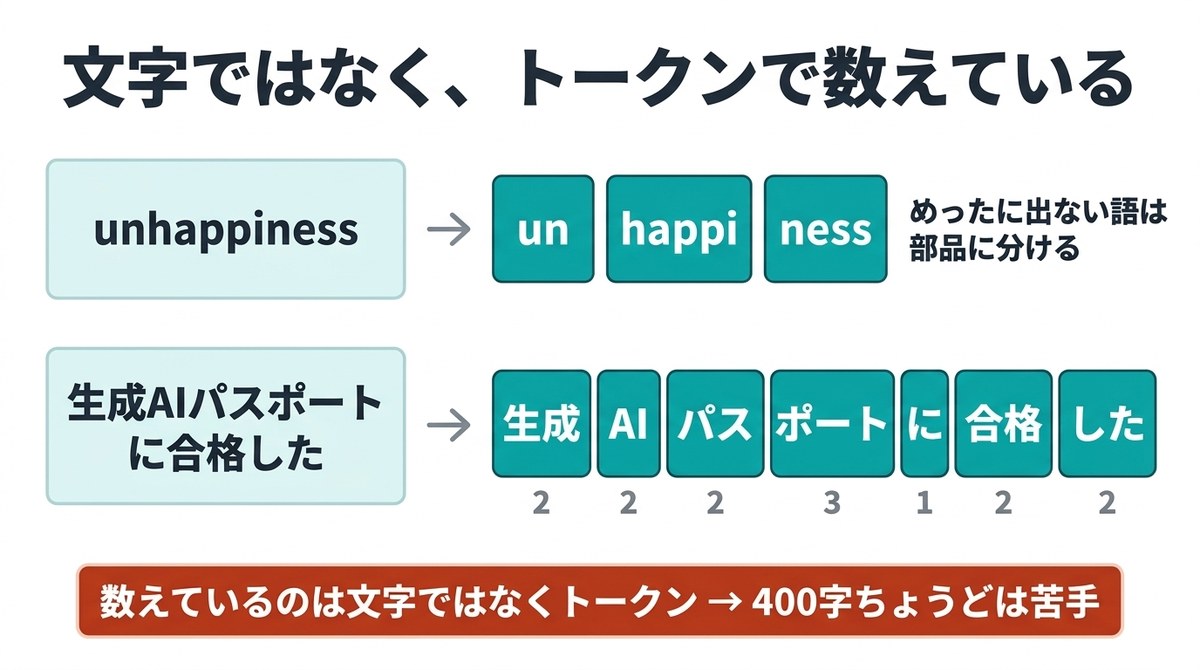
生成AIは、文章を人間のように1文字ずつ読んでいるわけではありません。まず文章をトークンという断片に区切ります。この作業をトークン化と呼びます。
よく使われるのは、サブワードという区切り方です。よく出てくる語はそのまま1つのトークンにし、めったに出てこない語は、より小さな部品に分けます。英語の「unhappiness」なら「un」「happi」「ness」のように分かれることがあります。日本語では、よく使う語が1トークンになることもあれば、1文字が1トークン、あるいは1文字が複数のトークンに分かれることもあります。区切り方はモデルごとに違います。
こうすると、限られた数の部品の組み合わせで、どんな語でも表せます。新語や固有名詞が出てきても、部品に分ければ扱えます。
文字数の指定が苦手な理由
モデルが数えているのは文字ではなくトークンです。しかも日本語では、1トークンが何文字にあたるかが語によって変わります。モデルは「いま何文字書いたか」を直接数えられないので、「400字ちょうどで」と頼んでも、350字や500字になることがよくあります。
字数に決まりがある文章は、「400字程度」と目安で頼み、できあがったものを人が数えて整えるのが確実です。
埋め込みとベクトル表現
トークンのままでは計算できないので、各トークンを数百〜数千個の数値の並びに置きかえます。この数値の並びをベクトル、トークンをベクトルに置きかえることを埋め込み(Embedding)と呼びます。
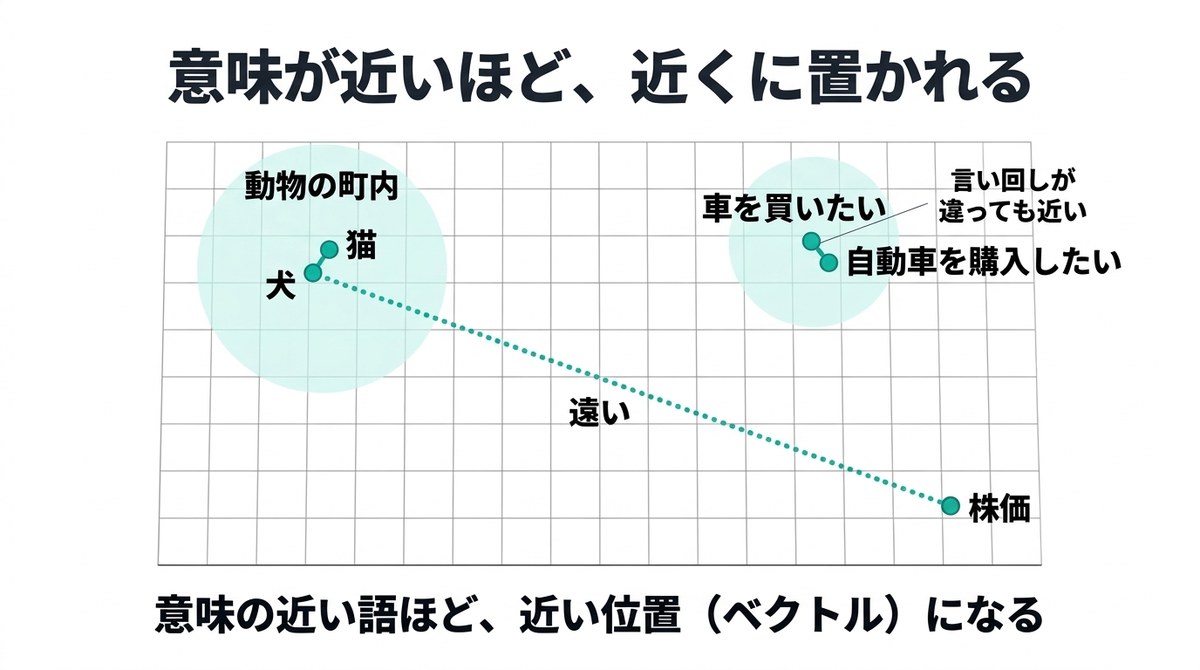
埋め込みでは、意味の近い語どうしが近いベクトルになるように学習されています。「犬」と「猫」のベクトルは近く、「犬」と「株価」は遠くなります。ベクトルを地図の上の住所のように考えると、似た意味の語は同じ町内に集まっている、というイメージです。
この性質のおかげで、モデルは言い回しが違っても意味の近さを扱えます。「車を買いたい」と「自動車を購入したい」は、語は違ってもベクトルで見ると近い位置にあります。文章どうしの意味の近さで探すRAGの検索も、この埋め込みを使っています(「RAG(検索拡張生成)とは?仕組み・発展形・ユースケース」)。
確率的な次トークン予測
ベクトルになった入力を、Transformer(「生成AIを支える技術革新(Transformer・GPT・拡散モデル)」)が読み、次に来るトークンの候補ごとに確率を出します。候補と確率の組を並べたものを確率分布と呼びます。
例:「昔々、あるところに」の次
| 候補 | 確率(例) |
|---|---|
| おじいさん | 60% |
| 小さな | 15% |
| 一人の | 10% |
| そのほかの候補 | 合わせて15% |
この中から1つを選び、入力の後ろに足します。「昔々、あるところにおじいさん」になったら、また次のトークンの確率を出して選ぶ。これを繰り返して文章ができあがります。生成AIの返事が少しずつ表示されるのは、トークンを1つずつ作っているからです。
大事なのは、毎回いちばん確率の高い候補を選ぶとは限らないことです。確率に応じてくじ引きのように選ぶので、同じ質問をしても答えが毎回少し変わります。
計算が苦手な理由
生成AIは、電卓のように決まった手順で確実に計算しているわけではありません。学習したパターンをもとに、次に来る語(数字)を確率で選んでいます。「1+1=」の次の「2」のように、学習データの中で何度も見た並びは正しく出せますが、桁の多い計算などでは、もっともらしい数字の並びを出して間違えることがあります。
正確な計算が要るときは、生成AIにプログラムを書かせて実行させる機能や、表計算ソフトを使います。
ハルシネーション
ハルシネーションは、生成AIが事実と違う内容を、もっともらしく出力することです。英語で「幻覚」を意味します。存在しない論文の題名を挙げる、実在しない法律の条文を書く、といった形で起きます。
起きる理由は、ここまでの仕組みから説明できます。
- モデルは「事実かどうか」ではなく「並びとして自然か」で次のトークンを選んでいる
- 学習データに無いことや少ないことを聞かれても、「分からない」より、それらしい続きを作るほうが自然な並びになりやすい
- 確率で選ぶので、たまたま確率の低い誤った候補が選ばれ、そこから後の文章がその誤りに沿って続いてしまう
最新の情報が苦手な理由
モデルが知っているのは、学習データを集めた時点までのことです。その後に起きた出来事は、パラメータの中にありません。それでも質問されると、古い情報や推測でもっともらしい答えを作ってしまうことがあります。
ハルシネーションや情報の古さを減らす方法の代表が、RAG(検索拡張生成)です。質問に関係する資料を検索してモデルに渡し、その資料をもとに答えさせます。Web検索と組み合わせた生成AIも同じ考え方です。仕組みは「RAG(検索拡張生成)とは?仕組み・発展形・ユースケース」で扱います。それでもゼロにはならないので、大事な内容は人が出典で確かめます(「AI出力の評価と検証(ファクトチェック・妥当性レビュー・検証レベル)」)。
生成パラメータ(Temperature・Top-p)
次のトークンをどう選ぶかは、利用者や開発者が設定で変えられます。この設定値を生成パラメータと呼びます。代表がTemperatureとTop-pです。どちらも、答えの「ばらつき」を調整します。
Temperature(温度)
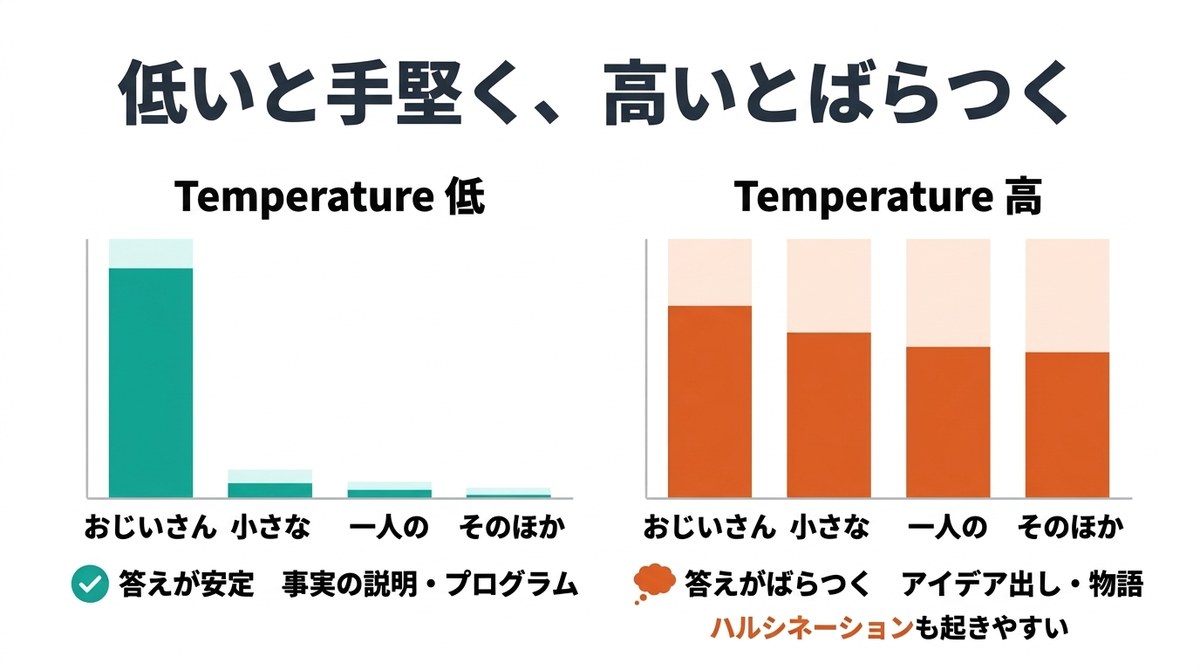
Temperatureは、確率分布の形をとがらせたり、なだらかにしたりする値です。
- 低くする:確率の高い候補がさらに選ばれやすくなる。答えが安定し、毎回似た内容になる。事実の説明、決まった形式の文書、プログラムの作成に向く
- 高くする:確率の低い候補も選ばれやすくなる。答えのばらつきが大きくなり、意外な表現が出やすい。アイデア出しや物語づくりに向く
Temperatureを高くすると、確率の低い候補が選ばれる機会が増えるので、ハルシネーションも起きやすくなります。
Top-p
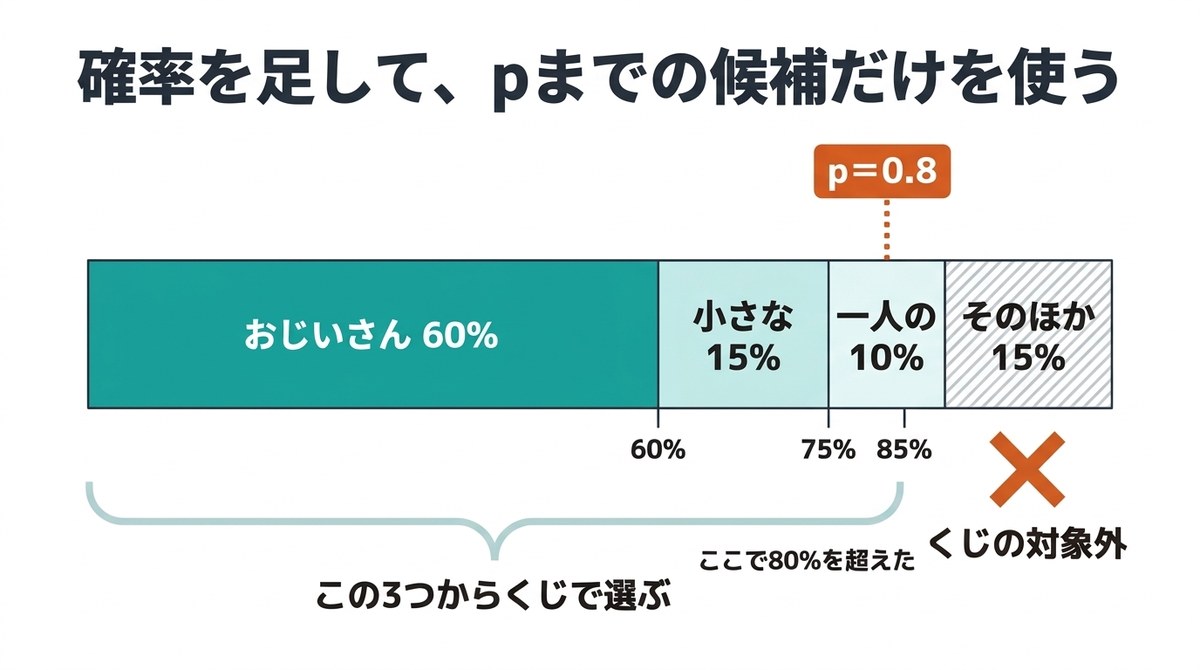
Top-pは、候補を確率の高い順に並べて、確率を足していき、合計がpに達するまでの候補だけをくじの対象にする設定です。
上の例でTop-pを0.8にすると、「おじいさん(60%)」「小さな(15%)」「一人の(10%)」で合計85%となり、80%を超えたところで打ち切ります。そのほかの候補は選ばれません。pを小さくするほど候補が絞られて手堅い答えになり、大きくするほど表現の幅が広がります。
TemperatureとTop-pはどちらもばらつきを調整するので、両方を同時に大きく動かすと結果が読みにくくなります。開発元の説明でも、どちらか一方を調整することが勧められています。なお、チャット画面ではこれらの値を利用者が直接変えられないことが多く、APIなど開発者向けの使い方で設定します。
コンテキストウィンドウ
コンテキストウィンドウは、モデルが1回の処理で読める入力と出力の量の上限です。単位はトークンです。会話の履歴、貼り付けた資料、指示文、モデル自身の答えが、すべてこの枠の中に入ります。
枠を超えた分は、モデルからは見えません。長い会話を続けると、最初のほうに伝えた条件を守らなくなることがあるのは、古いやりとりが枠から外れたり、長い入力の中で注意が届きにくくなったりするためです。
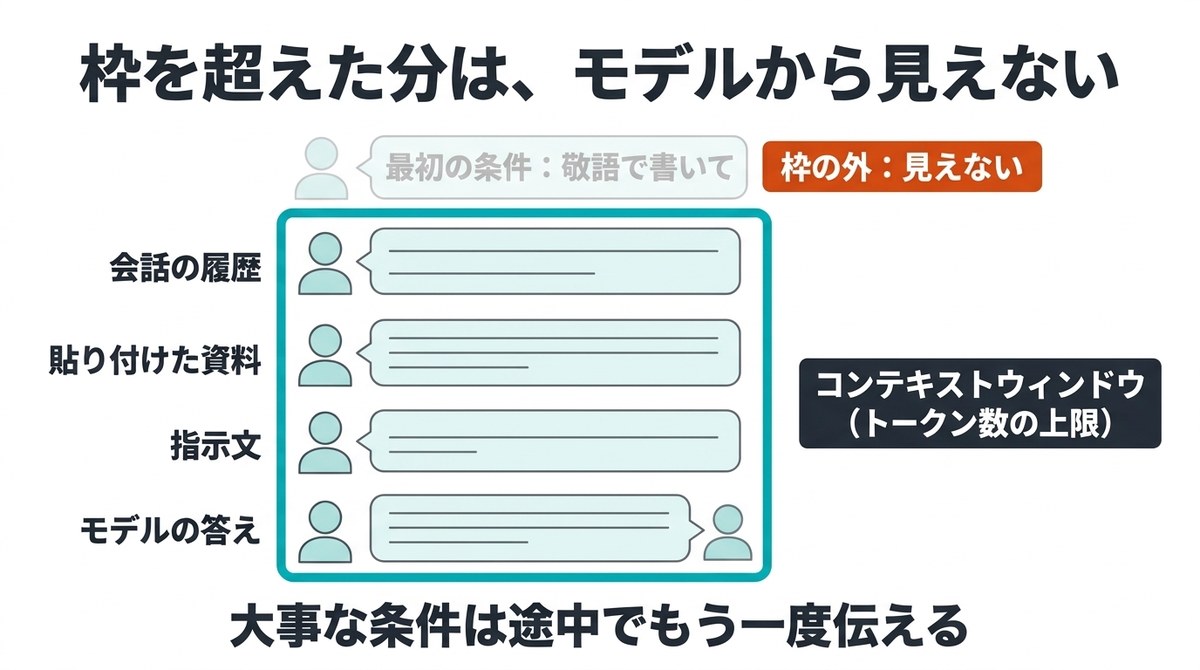
コンテキストウィンドウはモデルの世代が進むごとに広がり、2026年11月時点では本を何冊も読み込める規模のモデルもあります。それでも、大事な条件は会話の途中でもう一度伝える、長い資料は必要な部分に絞って渡す、といった工夫が役に立ちます。枠の中に何をどう入れるかを設計する考え方は、「AIエージェントの仕組み:計画・ツール実行・メモリ・フィードバックループ」で扱います。
この単元のまとめ
- 生成AIは、文章をトークン(サブワード)に区切り、埋め込みでベクトルにし、次のトークンを確率分布から1つずつ選んで文章を作る
- 文字数の指定が苦手なのはトークン単位で処理しているから。計算を間違えることがあるのは、決まった手順で確実に計算するのではなく、学習したパターンから次の語を確率で選んでいるから
- ハルシネーションは、事実かどうかではなく並びの自然さで選ぶ仕組みから起きる。RAGで減らせるがゼロにはならない
- Temperatureを低くすると答えが安定し、高くするとばらつく。Top-pは確率の合計で候補の範囲を絞る
- コンテキストウィンドウは1回に扱えるトークン数の上限。超えた分はモデルから見えない
この単元の問題8問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
生成AIの単元
