 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
AIエージェントは、LLM(大規模言語モデル)を中心に、いくつかの部品を組み合わせて動いています。この記事では、目標を小さな作業に分ける「計画」、外部の道具を使う「ツール実行」、作業の経過を覚えておく「メモリ」、LLMに何を見せるかを設計する「コンテキストエンジニアリング」を順に見て、最後にそれらが1つのループとして回る様子をまとめます。エージェントとは何かは 「AIエージェントとは?従来の生成AIとの違いと自律性のレベル」 で扱いました。
この単元を講義動画で見るIT資格の森の会員向け
講義3-3「AIエージェントの仕組み」(9分56秒)。この単元の内容を、動く図解で約10分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(3-1「AIエージェントとは」)。(IT資格の森とUdemyの違い・料金)
LLMを中核とした構成
AIエージェントの中心にあるのはLLMです。LLMが受け持つのは、状況を読んで「次に何をするか」を考える推論の部分です。ただしLLMそのものは文章を受け取って文章を返すだけで、ファイルを開いたり、Webを検索したりはできません。そこで、LLMのまわりに次の部品を組み合わせます。
| 部品 | 受け持つこと | ないと何が起きるか |
|---|---|---|
| 計画 | 目標を、順番のある小さな作業に分ける | 大きな依頼をいきなり一度に片づけようとして、抜けや誤りが出る |
| ツール | 検索・計算・ファイル操作・システムの操作など、外の世界に働きかける | 文章を返すだけで、実際の作業ができない |
| メモリ | それまでの経過や、以前に得た情報を覚えておく | 同じ調べものをくり返したり、前に決めたことを忘れたりする |
| ガードレール | やってはいけない操作や出力を止める | 誤った操作や不適切な出力がそのまま実行・公開される |
これらの部品をつなぎ、LLMの判断を実際の操作に変えるのは、エージェントを動かすプログラムの側です。LLMは「何をするか」を決め、プログラムがそれを実行する、という分担になっています。
タスク分解と計画
「競合3社の新製品を調べて、比較表を作って」という依頼を受けたとします。エージェントはまず、これを次のような小さな作業に分けます。
- 競合3社の名前を確かめる
- 各社の新製品の情報を検索する
- 価格・機能・発売時期を抜き出す
- 比較表にまとめる
このように大きな目標を作業に分けることをタスク分解、分けた一つひとつの作業をサブタスク、どの順でどう進めるかを決めることを計画と呼びます。人が仕事を始める前に段取りを組むのと同じです。サブタスクに分けておくと、どこまで終わったかが分かり、途中で失敗してもその作業だけやり直せます。
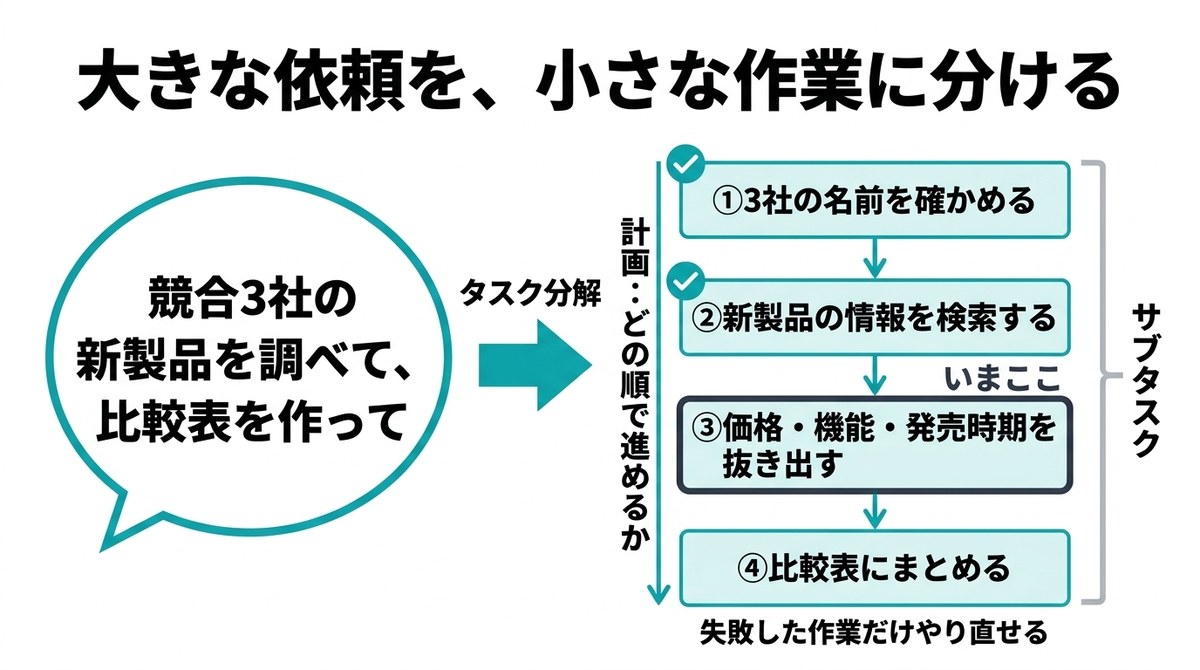
計画は最初に立てたら終わりではありません。作業を進めて新しい事実が分かれば、計画を立て直します(後の「フィードバックループ」の節)。
ツール実行:Function Calling と Tool Use
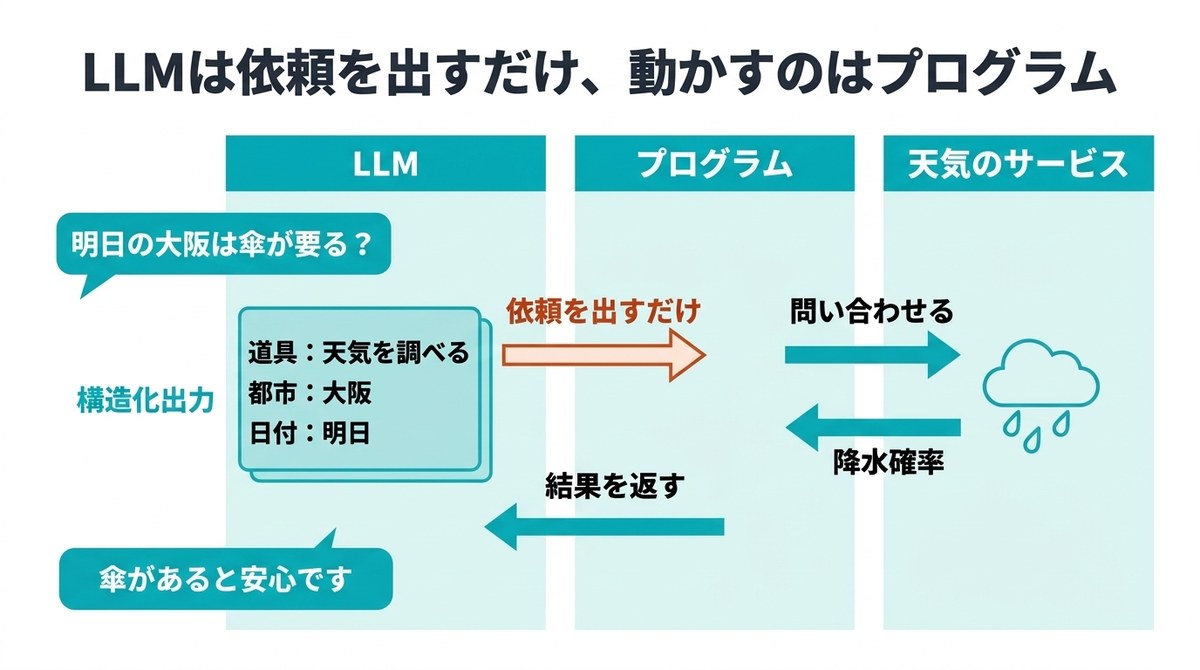
LLMが外部の道具を使うことをTool Use(ツール使用)、そのための代表的な仕組みをFunction Calling(関数呼び出し)と呼びます。試験でも問われやすいのが、誰が実際に道具を動かすのかという点です。天気を答える例で流れを見ます。
- プログラムは前もってLLMに「天気を調べる道具がある。使うときは都市名と日付を指定する」という道具の説明を渡しておく
- 人が「明日の大阪は傘が要る?」と聞く
- LLMは自分で答えず、「天気を調べる道具を、都市=大阪、日付=明日で呼んでほしい」という依頼を、決まった形式で出力する
- プログラムがその依頼を読み、実際に天気のサービスに問い合わせる
- 結果(降水確率など)をLLMに返すと、LLMがそれを読んで「傘があると安心です」と答える
3のとおり、LLMが出すのは「どの道具を、どんな値で呼ぶか」という依頼だけで、道具を実際に動かすのはプログラムの側です。だからこそ、プログラムの側で「この道具は使ってよい」「この操作は人の確認を待つ」と制御できます。
構造化出力:プログラムが読める形で出す
3の依頼は、ふつうの文章ではプログラムが読み取れません。そこで、項目名と値を決まった形式(JSONなど)で出力させます。決められた形式にそって出力することを構造化出力と呼びます。ツールの呼び出しのほか、「請求書から日付・金額・取引先を抜き出して表にする」のように、出力をそのまま別のシステムに渡したい場面でも使います。
記憶(メモリ)とコンテキスト管理
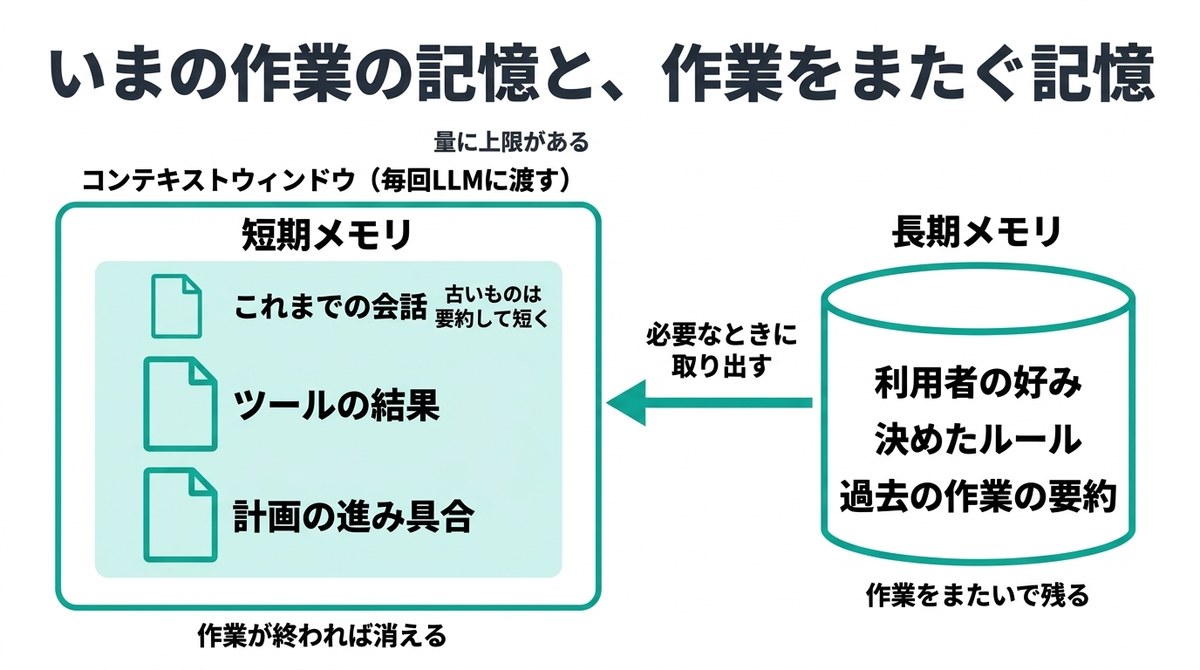
LLMは、1回の処理で渡された情報しか見ていません。前のやりとりを覚えているように見えるのは、プログラムが過去の会話を毎回まとめて渡しているからです。エージェントでは、この「何を覚えておき、何を渡すか」を記憶(メモリ)として扱います。
- 短期メモリ:いま進めている作業の中の記憶です。これまでの会話、使ったツールとその結果、計画の進み具合などで、LLMに毎回渡す情報(コンテキスト)の中に置かれます。作業が終われば消えるのが基本です
- 長期メモリ:作業をまたいで残す記憶です。利用者の好み、以前に決めたルール、過去の作業の要約などを外部のファイルやデータベースに保存しておき、必要なときに取り出して使います
短期メモリはコンテキストウィンドウ(1回に読める量の上限)に収める必要があります。長い作業では、古いやりとりを要約して短くする、使い終わったツールの結果を外す、といった整理をします。こうした、限られた枠の中に何を残すかを管理することをコンテキスト管理と呼びます。
コンテキストエンジニアリング
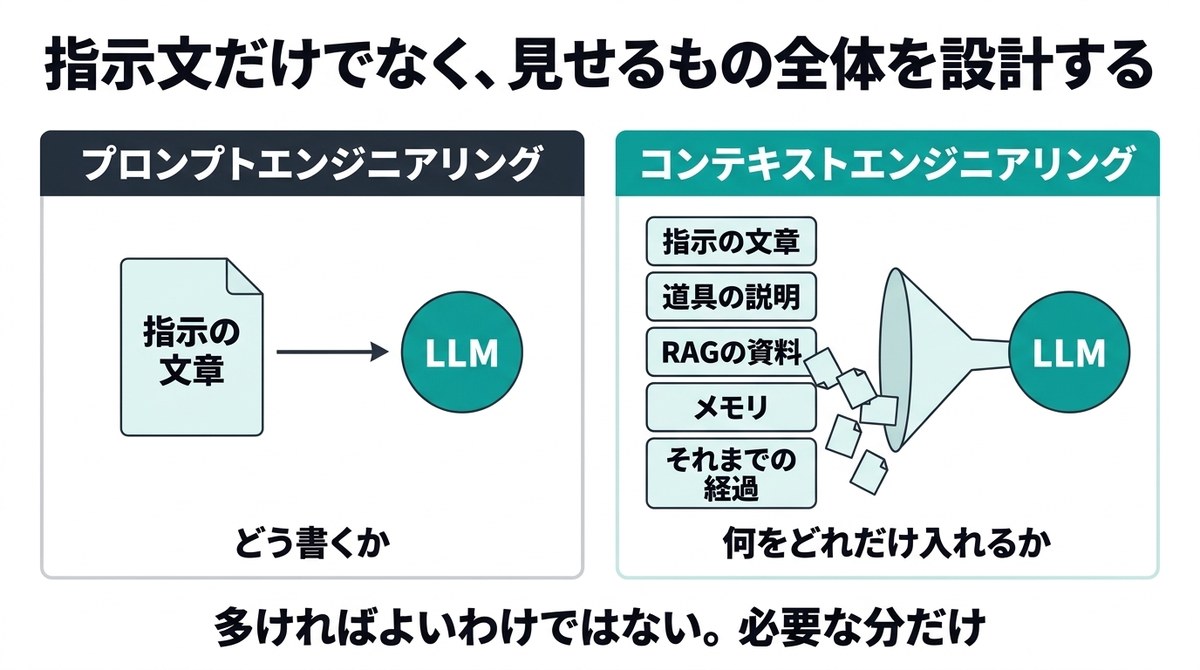
LLMの出来は、渡された情報の中身で大きく変わります。コンテキストエンジニアリングは、LLMに渡す情報の全体を、作業のたびに設計し、整えていく考え方です。Anthropic は2025年9月の技術記事で、これをプロンプトエンジニアリングが自然に発展したものとして説明しています。
プロンプトエンジニアリングとの違いは、扱う範囲です。
- プロンプトエンジニアリング:指示の文章をどう書くかの工夫(「プロンプトエンジニアリングの基礎(Zero-Shot・Few-Shot・Chain-of-Thought)」)
- コンテキストエンジニアリング:指示の文章に加えて、使える道具の説明、RAGで探してきた資料、メモリ、それまでの経過など、LLMに見せるもの全体を何をどれだけ入れるかの工夫
情報は多いほどよいわけではありません。量が増えると、モデルが必要な箇所を正しく拾いにくくなることが知られています。目標に合った情報を必要な分だけ入れるのが基本です。
システムプロンプトとガードレール
システムプロンプトは、利用者の質問とは別に、エージェントの役割や守るべき決まりを書いておく指示文です。「あなたは社内の経費精算を手伝うアシスタントです」「金額は必ず規程の表から引用する」といった内容を書き、毎回LLMに渡します。
ガードレールは、エージェントが外れてはいけない範囲を決め、外れそうな入力・出力・操作を止める仕組みです。システムプロンプトに「個人情報を出力しない」と書くだけでなく、プログラムの側で出力を点検する、特定の操作は実行前に人の承認を求める、といった形で何重にも組みます。安全面からの詳しい話は 「AIエージェントのリスク・安全性・評価:プロンプトインジェクションと最小権限の原則」 で扱います。
推論と行動のフィードバックループ
ここまでの部品は、次のようなループとして回ります。
- 推論:目標と、これまでの経過を読んで、次に何をするかを考える
- 行動:ツールを呼び出して実行する
- 観察:ツールの結果を受け取り、うまくいったか、何が分かったかを見る
- 再計画:結果に合わせて、残りの計画を立て直す。目標を達成していれば終える
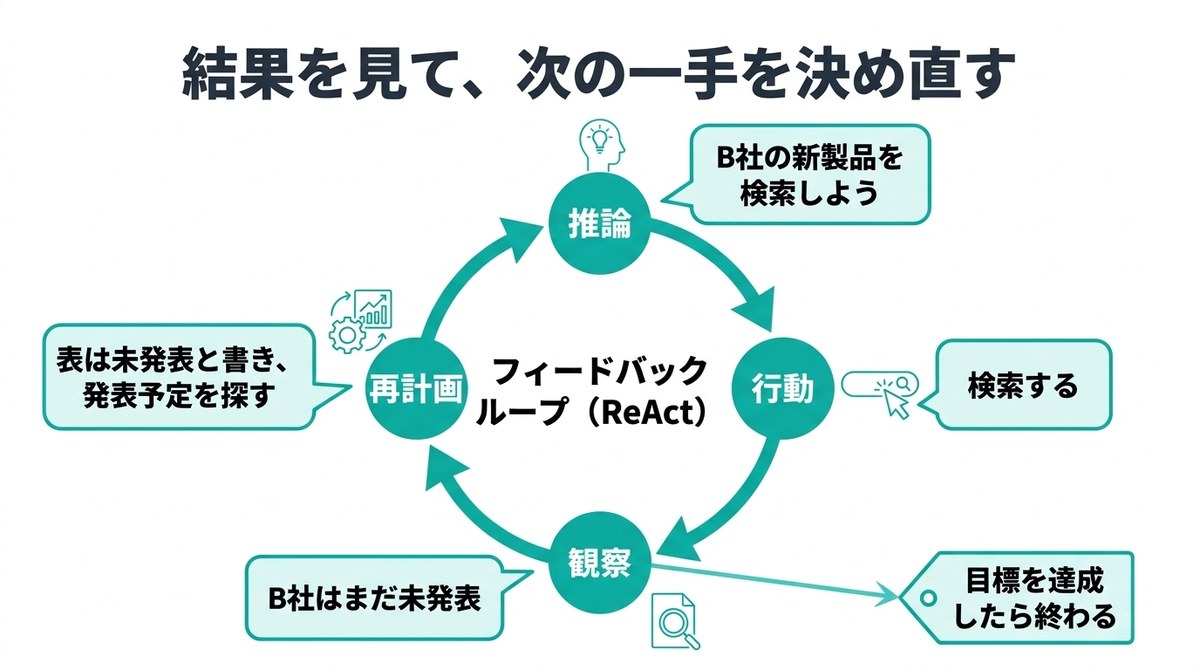
結果を見て次の行動を変えるこの流れをフィードバックループと呼びます。先の競合調査の例なら、検索したらB社の新製品はまだ発表されていなかった(観察)、だから比較表は「未発表」と書き、代わりに発表予定の情報を探す(再計画)、という動きです。推論と行動を交互にくり返すこの考え方は、2022年に発表された研究「ReAct」(Reasoning+Acting)で広く知られるようになりました。
ループには弱点もあります。前の段階の誤りに気づかないまま次の行動に進むと、誤りが積み重なって大きくなります。何回までくり返すか、どこで人が確認するかを決めておくのはそのためです(「AIエージェントのリスク・安全性・評価:プロンプトインジェクションと最小権限の原則」)。
この単元のまとめ
- エージェントの中心はLLMで、推論(次に何をするかの判断)を受け持つ。実際の操作はまわりのプログラムとツールが行う
- Function Callingでは、LLMは「どの道具をどんな値で呼ぶか」を構造化出力で出すだけで、道具を動かすのはプログラムの側
- 短期メモリはいまの作業の経過、長期メモリは作業をまたいで残す情報。限られたコンテキストに何を残すかを管理する
- コンテキストエンジニアリングは、指示文だけでなく道具の説明・資料・メモリなど、LLMに見せるもの全体を設計する考え方
- 推論 → 行動 → 観察 → 再計画のフィードバックループで、途中の結果を見ながら目標に近づく
この単元の問題9問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
AIエージェントの単元
- 3-1AIエージェントとは?従来の生成AIとの違いと自律性のレベル
- 3-2RAG(検索拡張生成)とは?仕組み・発展形・ユースケース
- 3-3AIエージェントの仕組み:計画・ツール実行・メモリ・フィードバックループいま読んでいるページ
- 3-4MCP・Agent Skills と外部連携:A2A・マルチエージェントまで
- 3-5AIエージェントのツールと活用事例:コーディングエージェントからディープリサーチまで
- 3-6AIエージェントのリスク・安全性・評価:プロンプトインジェクションと最小権限の原則
