 過去問の代わりに解ける無料問題
2027年2月試験 新シラバス版
この記事は、2027年2月試験から適用される新しいシラバス(出題範囲)に対応しています。改訂版の公式テキストの発行後に、内容を見直して改善する予定です。
この記事では、データを整える・数える・調べる仕事で生成AIをどう使うかを扱います。表のデータの扱い方から、Webを横断して調べるディープリサーチ、毎週のレポートの自動化まで、使い方と確かめ方が分かります。
この単元を講義動画で見るIT資格の森の会員向け
講義5-5「データ分析・リサーチ業務での活用」(7分47秒)。この単元の内容を、動く図解で約8分にまとめています。この回の動画は、IT資格の森の会員向けです。各章の1本目は無料で見られます(5-1「プロンプトエンジニアリングの基礎」)。(IT資格の森とUdemyの違い・料金)
データの整形・分類
整形:形をそろえる
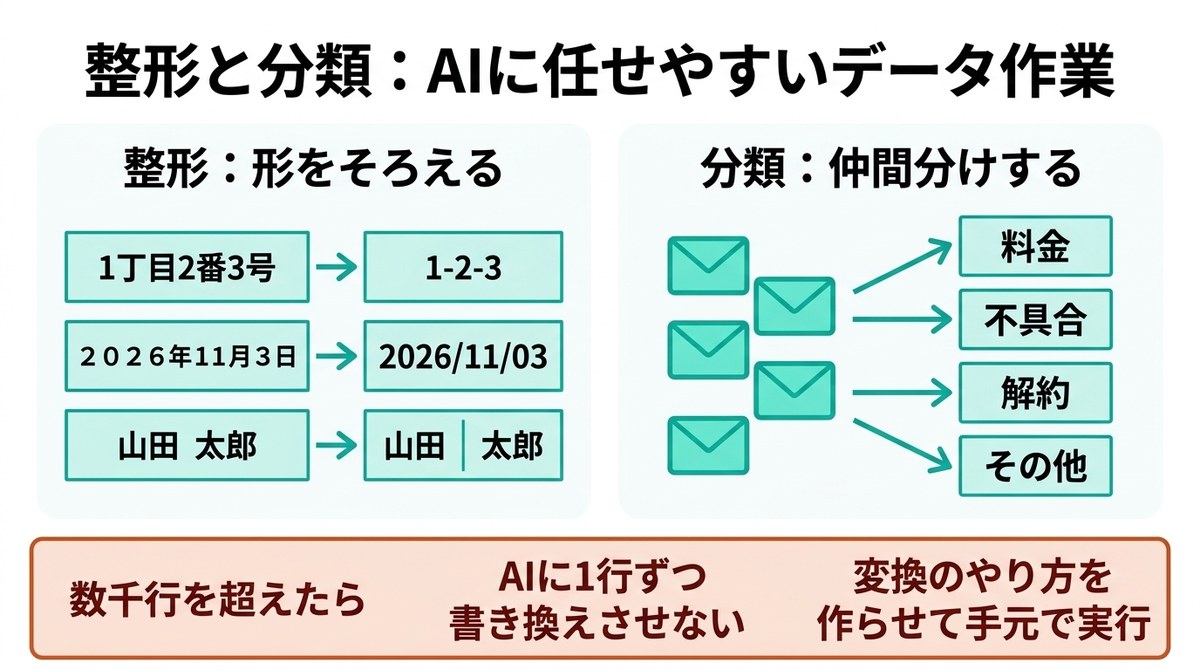
データの整形は、ばらばらな書き方を、集計や検索に使える形にそろえる作業です。たとえば、住所の「1丁目2番3号」と「1-2-3」をそろえる、全角と半角を統一する、日付を「2026/11/03」の形にそろえる、氏名を姓と名の列に分ける、といった作業です。
数十行なら、データを貼り付けて「この形にそろえて」と頼めば済みます。数千行を超えるような量では、AIにデータを1行ずつ書き換えさせるより、変換のやり方(表計算ソフトの関数やプログラム)を作らせて、それを手元で実行するほうが確実です。AIに書き換えさせると、途中の行が抜けたり、勝手に値が変わったりすることがあるからです。
分類:仲間分けする
分類は、データを決めた区分に振り分ける作業です。問い合わせのメールを「料金」「不具合」「解約」「その他」に分ける、商品レビューを良い・悪いに分ける、といった、文章の意味を読んで判断する作業が向いています。区分の基準と例をいくつか示すと(Few-Shot。「プロンプトエンジニアリングの基礎(Zero-Shot・Few-Shot・Chain-of-Thought)」)、振り分けがそろいます。
個人情報の入ったデータ
顧客の名簿や問い合わせの記録には、個人情報が含まれます。分析に名前や連絡先が要らないなら、AIに渡す前に削るか、記号に置き換えます。そのうえで、社内で使ってよいと認められたツールを使います(「個人情報保護法と生成AI(個人情報・プライバシー・秘密保持)」)。
表・データの集計と可視化
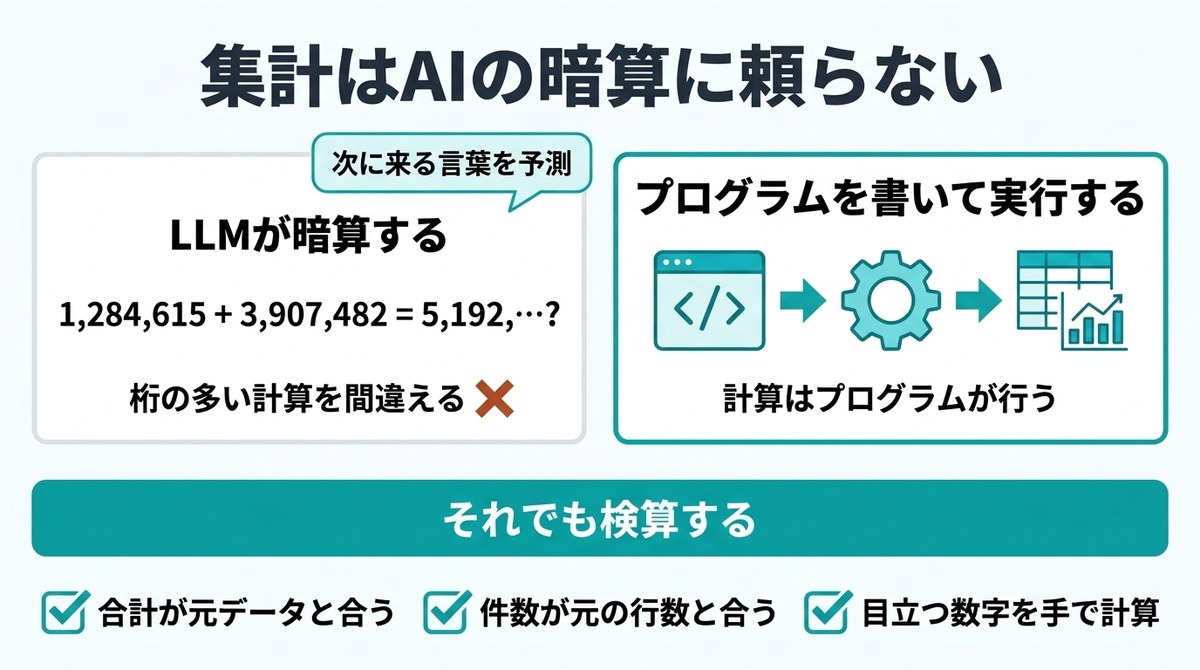
集計は、データを足したり数えたりして、合計や平均、割合を出すことです。ここで知っておきたいのは、LLM(大規模言語モデル)が計算そのものを苦手としている点です。LLMは次に来る言葉を予測して文章を作る仕組みなので、桁の多い計算や大量の数の合計を間違えることがあります(「生成AIの生成(推論)プロセスと、生成AIが苦手なこと」)。
そのため、多くの生成AIサービスには、AIがプログラムを書いて実行し、その結果を使って答える機能があります。計算はプログラムが行うので、AIが暗算するより正確です。表のファイルを渡して「支店別・月別の売上の合計を出し、折れ線グラフにして」と頼めば、集計とグラフ化(可視化)をまとめて進められます。
検算を習慣にする
プログラムで計算しても、どの列を足したか、どの行を除いたかを取り違えていれば、答えは間違います。結果を使う前に検算をします。全体の合計が元のデータの合計と合うか、件数が元の行数と合うか、目立つ数字をいくつか手で計算して一致するか、を見ます。AIに「どの列をどう計算したかを説明して」と頼むと、取り違えに気づきやすくなります。
大量文書からの情報抽出・要約
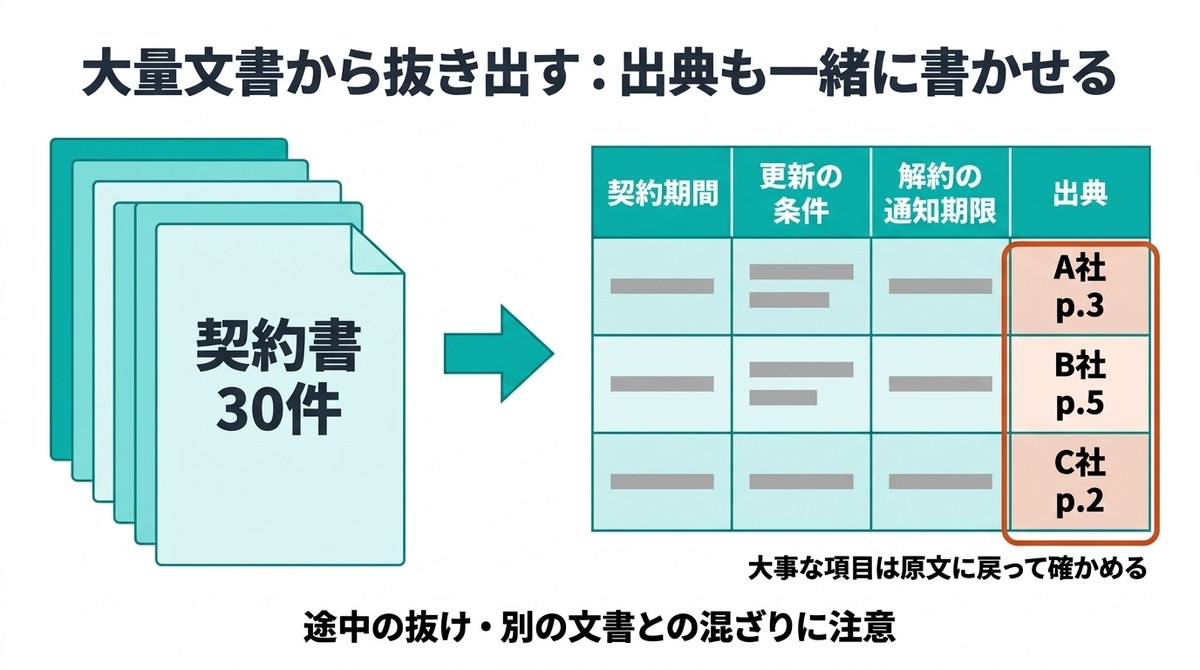
契約書、報告書、論文、議事録のように、文書がたまっていく仕事では、必要な情報を探すだけで時間がかかります。生成AIに「この30件の契約書から、契約期間・更新の条件・解約の通知期限を抜き出して表にして」と頼めば、読み比べる手間を大きく減らせます。
社内の大量の文書を、質問に合わせて検索し、見つかった部分をもとに答えさせる仕組みがRAG(検索拡張生成)です。社内規程や製品マニュアルについての質問に答える仕組みなどに使われています。仕組みは「RAG(検索拡張生成)とは?仕組み・発展形・ユースケース」で扱います。
長い文書では、途中の記述が抜け落ちたり、別の文書の内容が混ざったりすることがあります。抜き出した項目ごとに「どの文書の何ページか」を書かせておけば、大事な項目だけ原文に戻って確かめられます。
ディープリサーチ:複数ソースを横断調査
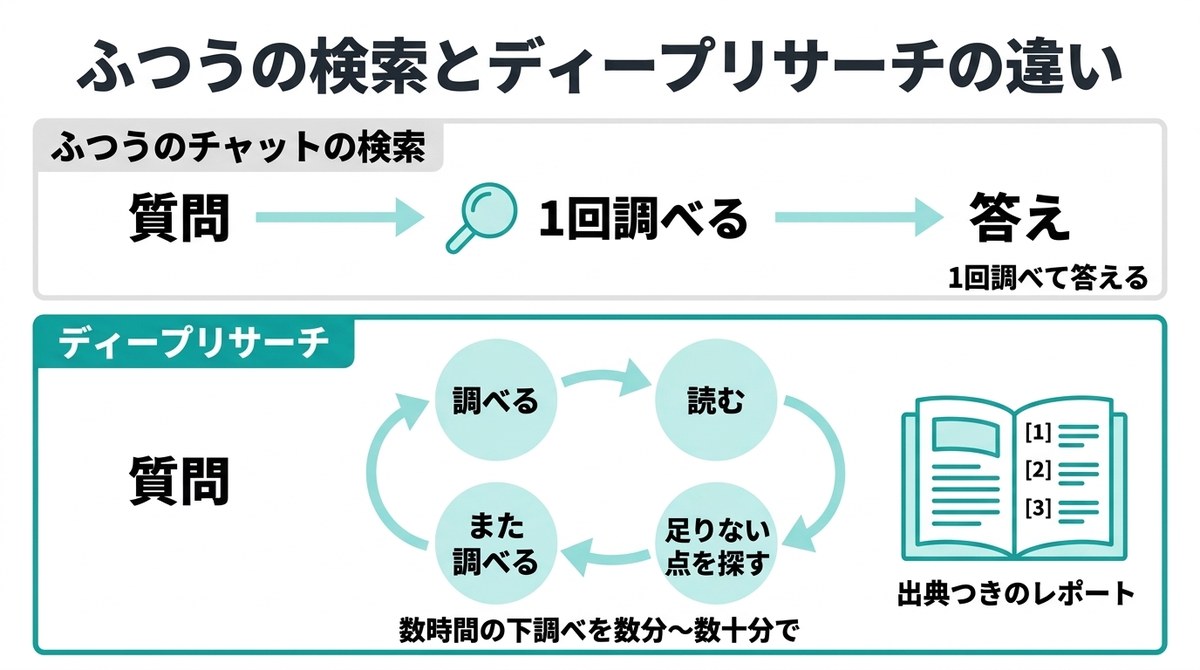
ディープリサーチは、AIが調べる手順を自分で決めて、Web上の多くの情報源を検索し、読み、足りない点をさらに調べ直したうえで、出典つきのレポートにまとめる機能です。人が数時間かけていた下調べを、数分から数十分で終えられます。2026年11月時点で、主要な生成AIサービスの多くに同じような機能があり、名前はサービスごとに違います。
頼むときは、調べたいことの範囲をはっきりさせます。「国内の中小企業向けの勤怠管理サービスについて、主な機能と料金体系の違いを、公式サイトの情報を優先して比べて」のように、対象・観点・優先する情報源を書くと、的外れな調査が減ります。
ふつうのチャットの検索が「1回調べて答える」のに対し、ディープリサーチは「調べる→読む→足りない点を探す→また調べる」を何度も繰り返します。AIエージェントの一種で、その仕組みは「AIエージェントのツールと活用事例:コーディングエージェントからディープリサーチまで」で扱います。
出典がついていても確かめる
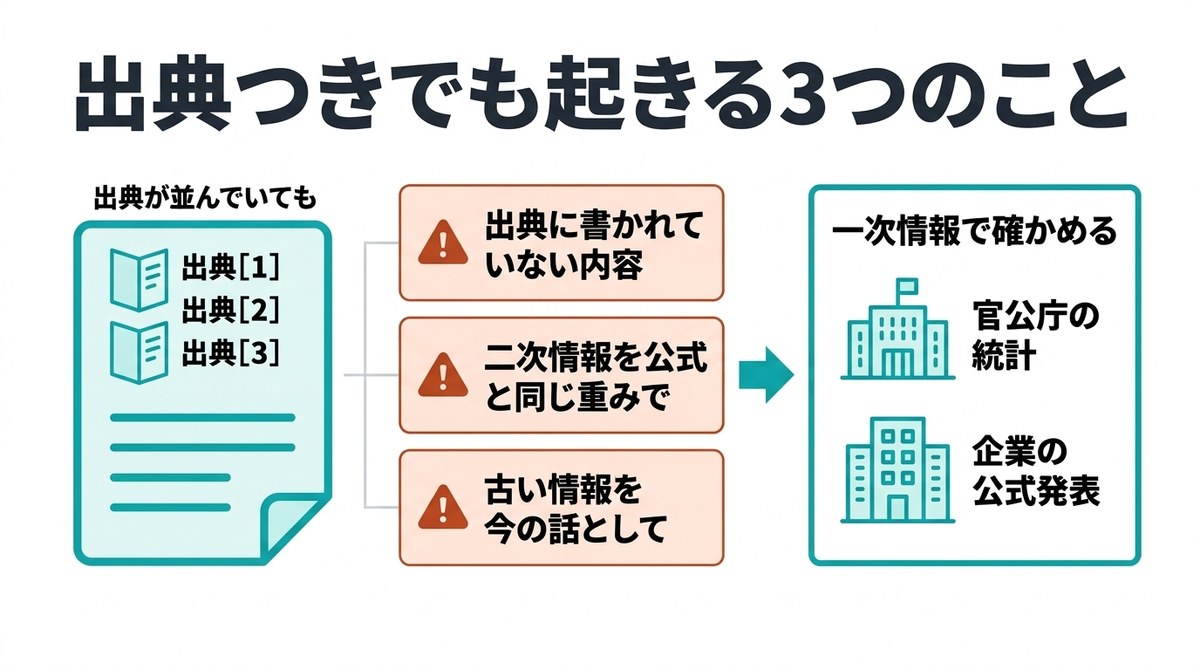
レポートに出典が並んでいると、正しそうに見えます。それでも、次のようなことが起きます。
- 出典のページは実在するが、そのページには書かれていない内容が書かれている
- 個人のブログやまとめ記事のような二次情報を、公式の情報と同じ重みで扱っている
- 何年も前の古い情報を、いまの話として書いている
判断に使う数字や事実は、一次情報(調査や発表をした本人の元の情報。官公庁の統計や企業の公式発表など)までたどって確かめます。ディープリサーチは、調べる範囲を広げ、どこを読めばよいかを見つける道具として使います(確かめ方は「AI出力の評価と検証(ファクトチェック・妥当性レビュー・検証レベル)」)。
定例レポートの自動生成
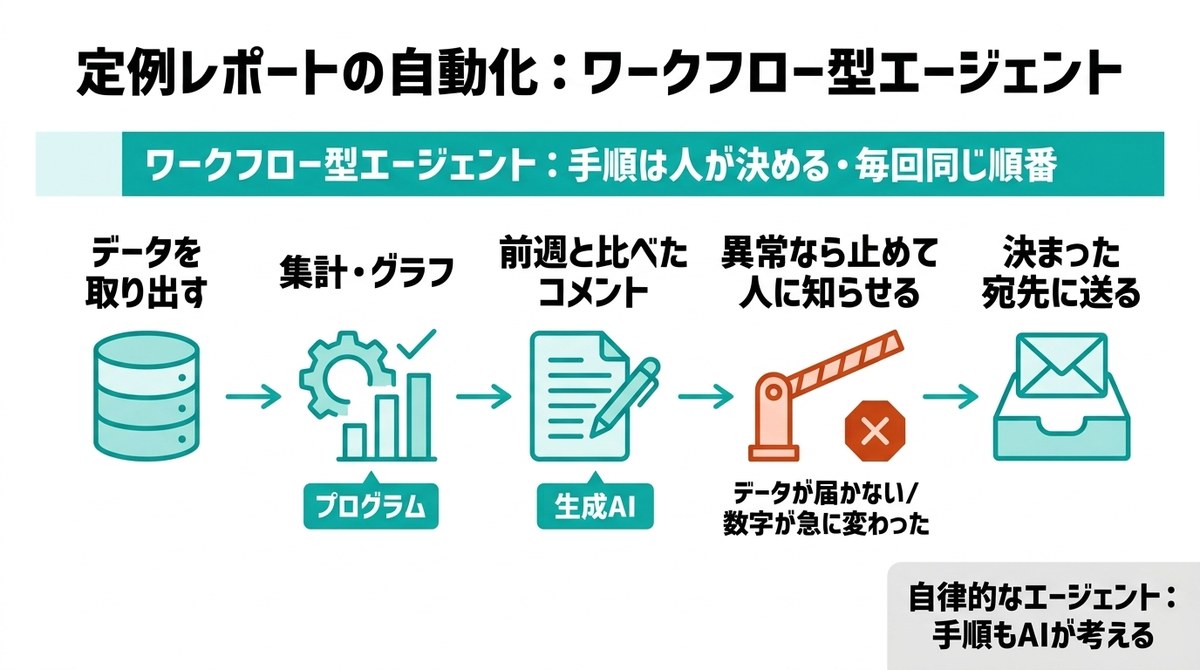
毎週の売上報告や毎月のアクセス解析のように、同じ形のレポートを繰り返し作る仕事は、自動化に向いています。たとえば「データを取り出す→集計してグラフにする→前週と比べたコメントを書く→決まった宛先に送る」という流れです。
このように、手順をあらかじめ決めておき、その一部の段階で生成AIを使う仕組みをワークフロー型エージェントと呼びます。AIが手順そのものを自分で考えて進める自律的なエージェント(「AIエージェントとは?従来の生成AIとの違いと自律性のレベル」)と違い、毎回同じ順番で動くので、結果が安定し、どこで問題が起きたかも追いやすくなります。決まった形の定例業務では、こちらが選ばれることが多くなります。
自動化しても人の確認を残す
数字はプログラムで計算し、生成AIにはコメントの文章だけを書かせる、という分け方が安全です。そのうえで、元データが届かなかったときや、前週から急に大きく変わった数字が出たときは、送る前に止まって人に知らせる仕組みを入れておきます。自動で送られるレポートは、誤りがあっても誰にも気づかれないまま広がりやすいからです。
この単元のまとめ
- データの整形・分類はAIに任せやすい。量が多いときは変換のやり方を作らせて手元で実行し、個人情報は削ってから渡す
- LLMは計算が苦手なので、集計はプログラムを実行する機能を使い、合計や件数を検算する
- 大量文書からの情報抽出では、どの文書の何ページかを書かせて原文を確かめる。社内文書の検索にはRAGが使われる
- ディープリサーチは調べて読むことを繰り返し、出典つきで報告する。判断に使う事実は一次情報で確かめる
- 定例レポートは、手順を決めたワークフロー型エージェントで自動化し、異常のときに止まって人が確認する仕組みを残す
この単元の問題6問
読んだ内容を1問ずつ確かめられます。選ぶとすぐに正誤と、選択肢ごとの解説が出ます。
生成AIの実践と活用事例の単元
